AI Engineer Europe 2026 · 演講 · 2026-04-28 · 26 分
評估平台為何難自己做
Why building eval platforms is hard · Phil Hetzel,Braintrust
Braintrust 的 Phil Hetzel 依序拆解團隊做 eval 平台的四個階段,從試算表到 observability 飛輪,說明真正的難處在資料層,不在介面。
概要
- 從試算表開始就對了Phil 認為最重要的是先動手,有一份試算表、一個 for loop、一個能執行 agent 的方法就夠起步。但這比較像記錄,不算實驗,人工評分也很難放大。
- 自己 vibe code 介面是第二步做出比較順手的 UI,再搬到正式資料庫,能讓更多人加入。可是這時仍偏向回報與文件,還沒有鼓勵反覆迭代。
- Playground 讓非工程師也能實驗使用者可以在介面上改 agent 的系統指令,比較兩種設定,再用 eval 把分數帶出來。
- Observability 與 evals 是同一個問題Phil 說三年前 Braintrust 剛成立時只做 evals,後來發現有客戶把全部 production 流量灌進去跑 eval,才補上 tracing。把正式環境的資料拉回離線 eval,形成一個循環。
- 難處在資料層agent trace 又大、又非結構化、又密集,Phil 說跟一般應用程式的 trace 很不一樣,單靠一個資料庫撐不住,要同時兼顧即時查看與聚合分析。
- 下一步是給 agent 用的平台Phil 提到的方向有用 topic modeling 找出沒想到的使用方式、讓 coding agent 直接下 SQL,以及用 gateway 自動加上 tracing。
原話
▶ 10:13“EVALs are a team sport, kind of what I was talking about before.”
eval 是團隊運動,要把非技術的人也拉進來
▶ 14:21“Observability and evals, to us, it's actually the same problem from a systems perspective.”
對我們而言,observability 與 evals 從系統角度看是同一個問題
▶ 16:16“almost like you're rerunning production in a safe environment.”
跑 eval 就像在安全的環境裡重跑一次 production
▶ 16:50“if you build it you have to manage it”
自己做的平台就得自己維護
▶ 19:37“It's actually a systems problem, it's not just a UI, UX problem.”
衡量 agent 品質其實是系統問題,不只是介面問題
延伸
- Phil 提到 Braintrust 有一篇剛發布的部落格,講他們現在怎麼處理資料層,但這場沒有展開。
- 權限控管、資料遮罩這類非功能需求 Phil 今天沒談,只說那是要大規模運作時才會碰到的。
章節
點時碼直接跳到原片的那一段。
- 開場與議程Phil 先請全場一起喊 evals,再預告今天依序談自我介紹、問題、建置階段與未來走向。
- Phil 的背景Phil 帶 Braintrust 的 solutions engineering,之前做過 12 年顧問,看到客戶的 generative AI POC 很難上線,才轉來用 Braintrust。
- Agent quality 平台Braintrust 把 agent 品質分成 evals(上線前)與 observability(上線後)兩根柱子,Phil 說這兩件事很像。
- 為什麼需要 evalsLLM 變化極大,加上 agent 已成常態,沒有信心就上線,會有品牌、法遵、成本與維運上的風險。
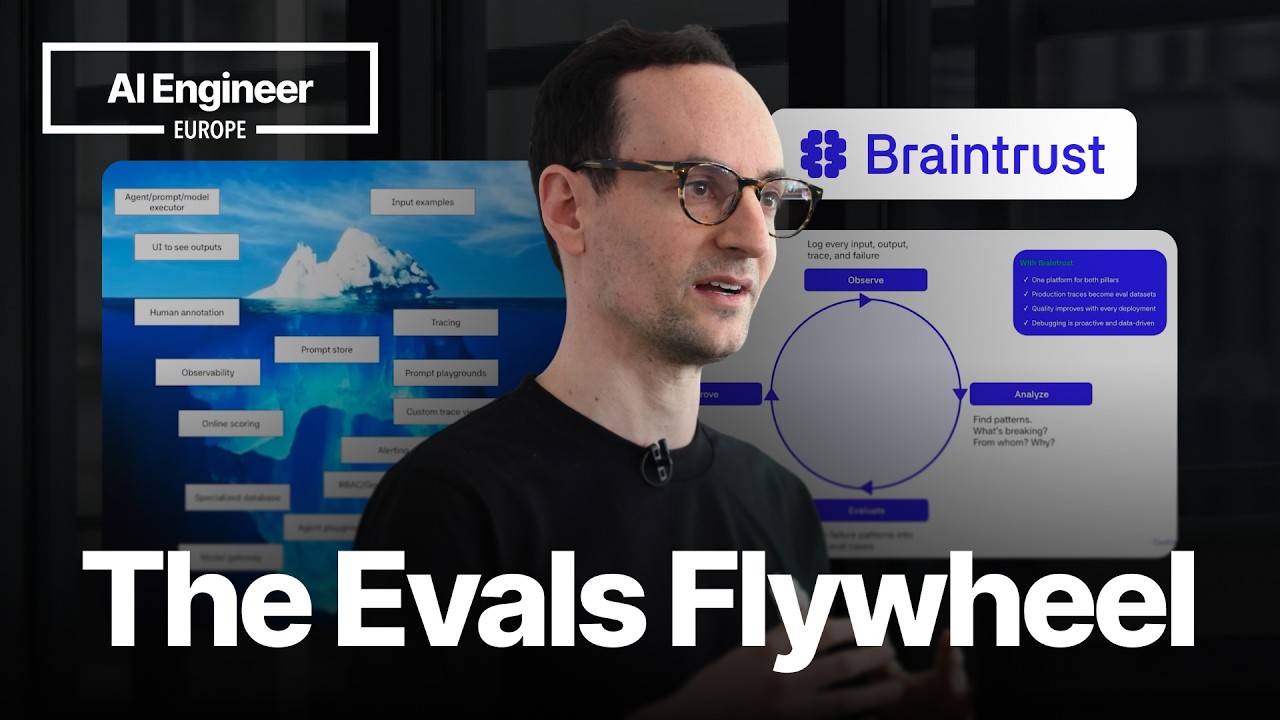
- 冰山之下有人覺得只要 loop 過 agent、顯示分數就夠,Phil 說真正認真做 evals 要蓋的東西遠不止這些,原因包括技術複雜與牽涉多種角色。
- 階段一:試算表試算表加 for loop 是好起點,但難以比較不同實驗、分析有限、非技術同事不會進來看。
- 階段二:自己做 UI用 vibe coding 做出貼合使用者的介面,資料也有了資料庫,但仍然只是報告工具。
- 階段三:實驗與 playground讓使用者改 agent 設定,比較兩組系統指令的 eval 分數,技術與非技術使用者都該有。
- 階段四:飛輪從客戶把 production 流量灌進 eval 的故事談起,把正式環境資料拉回離線改善,並加上 online eval 與告警。
- 自己做就要自己養平台要隨產業速度長大,而且 agent trace 與一般 trace 不同,又大又非結構化。
- 舊架構與撞牆他們原本用即時寫入加開源資料倉儲,再用自創的 btql 串起來,最後在瀏覽器用 DuckDB 聚合,遇到 Notion 這類全文搜尋需求就不夠用。
- 其實是系統問題介面很容易 vibe code,資料層才難;傳統 span 約幾 KB,這裡見過 10、20 MB 的。
- Headless 與 coding agent想讓 coding agent 自己撈資料改 agent,後端就要能跑純 SQL,Phil 說有人根本不看 UI。
- 接下來會有的功能用 topic modeling 找 unknown unknowns、為 agent 而不只是為人設計、權限與資料遮罩,以及 gateway 自動 tracing。
- Q&A有聽眾問多模態,Braintrust 把檔案放物件儲存並在 trace 裡直接播放;另一題問 prompt management,Phil 說可以放也可以不放。
名詞
- Braintrust
- Phil 任職的公司,自稱 agent quality 平台,靠 evals 與 observability 兩根柱子
- Eval
- 在 agent 上線前實驗時用來建立信心的評估
- Observability
- 上線後持續確認 agent 表現符合預期的做法
- Playground
- 讓使用者改 agent 設定並比較結果的實驗介面
- Flywheel
- Phil 對 observability 與 evals 互相餵資料的循環的稱呼
- btql
- Braintrust 自創的查詢語言,Phil 說連他們自己都不喜歡
- DuckDB
- 舊架構裡在瀏覽器端做第三層聚合用的工具
- Notion
- Phil 舉的客戶例子,傳來大量非結構化資料,想做 trace 的全文搜尋