AI Engineer Europe 2026 · 演講 · 2026-05-09 · 19 分
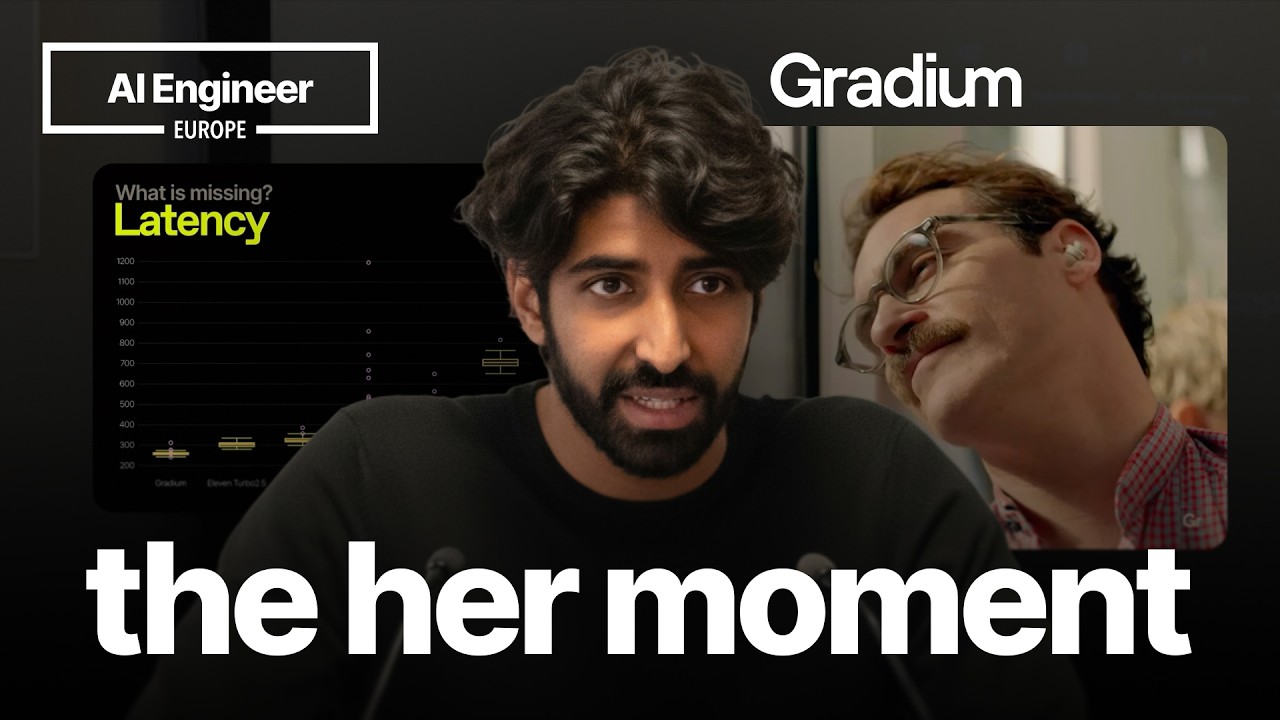
語音 AI 離《Her》還差什麼
Voice AI: when is the "Her" moment? · Neil Zeghidour,Gradium AI
Gradium 執行長 Neil Zeghidour 拿《Her》當尺,檢視語音 AI 在延遲、全雙工、成本與隱私上還缺什麼,並介紹裝置端 TTS。
概要
- 現有 demo 還沒到《Her》Neil 看了 ElevenLabs 與自家的 demo,認為延遲仍高、無法處理同時說話,而且多半是替文字模型加一層聲音。
- 瓶頸從 TTS 轉到 tool call串接式系統光 TTS 就超過 200 毫秒,Neil 說 tool call 的延遲在 500 毫秒到四秒之間,比再省幾毫秒更關鍵。解法之一是等結果時用填充語把對話接下去。
- 全雙工才像人類對話Neil 說除了 Moshi 之外,所有 speech-to-speech 模型都是半雙工,一遇到附和或重疊就會壞掉;但全雙工模型缺少 tool call 與可觀測性,短期還取代不了串接式系統。
- 成本是規模化的牆Neil 說 LLM 的費用幾乎可以忽略,帳單主要是 TTS,有人把募到的錢燒在 TTS 上,用戶都還沒長起來。
- 隱私推向裝置端Gradium Phonon 是在手機 CPU 上跑的 TTS,Neil 說小於 100 million,並開放私人 beta。
- 立場Neil 反對「語音已經是 commodity」的說法,認為這還是科學與工程問題。
原話
▶ 05:19“this is mostly just glorify the text model with a voice around it.”
現在的語音 agent 多半只是替文字模型包一層聲音
▶ 07:11“i think now the main bottleneck is becoming the tool call, which is very unpredictable.”
現在主要的瓶頸是 tool call,而且很難預測
▶ 09:55“Full duplex, that's a human conversation.”
全雙工才是人類的對話
▶ 14:06“It's impossible to use in production something that has no observability.”
沒有可觀測性的東西,不可能拿去上線
▶ 15:46“The voice mode of most hyperscalers is run at a loss.”
大型雲端業者的語音模式多半是虧錢在跑
延伸
- Neil 點名 OpenAI 的 advanced voice 與自己很欣賞的 Sesame,說連它們也還是半雙工。
- 裝置端模型 Neil 只拿 KOKORO 當對照,說它不錯但沒有語音複製,其他比較沒有展開。
章節
點時碼直接跳到原片的那一段。
- 開場與 Gradium 定位Gradium 做語音模型的積木:speech-to-text、text-to-speech、speech-to-speech,不碰 orchestration 與特定產業,並放了一段複製出來的 Joe Rogan 聲音,說只要錄約 10 秒。
- 從非營利實驗室分出來Gradium 是兩年前成立的非營利實驗室的分拆,那個實驗室做出 Moshi,並以開放研究為主。
- Her 的類比Neil 承認這是最被用爛的類比,但這部 13 年前的電影,主角初次遇見 AI 的那一幕,仍像是預示了互動的樣子。
- 現況示範放 ElevenLabs 的政府客服 demo 與自家做的健身夥伴 demo,Neil 的結論是兩者都還沒到位。
- 差在哪延遲偏高、處理雙方同時說話的能力不足,而且多半只是替文字模型包一層聲音。
- 串接式系統的延遲speech-to-text、LLM、text-to-speech 的串接架構,光 TTS 就超過 200 毫秒,而人類對話要整套理解到回應都在 200 毫秒左右。
- 瓶頸變成 tool call大家在 TTS 上搶 10 或 20 毫秒,但 tool call 的延遲在 500 毫秒到四秒之間,Neil 認為那才是現在的主要瓶頸。
- 用填充語撐住等待LLM 一邊等工具結果一邊接著聊,Neil 現場拿一個 vibe coding 做的旅遊 agent 示範,它查資料時先講幾句目的地的好話。
- speech-to-speech 的半雙工問題一個模型直接收聲音、吐聲音,延遲少很多,但除了 Moshi 之外都是半雙工,聽和說只能擇一。
- 全雙工與 backchanneling人類對話會重疊、會附和,日文裡附和代表禮貌與專心,重疊可達兩成時間。Neil 放了自己在旅館房間錄的影片,示範半雙工模型被附和聲打斷。
- Moshi 的全雙工示範放共同創辦人 Alex 與 Moshi 的對話,模型能搶在話說完之前回答,也能被插話。
- 語氣與副語言聲音裡的情緒線索 speech-to-speech 模型本來就收得到,但訓練資料若全是事實問答,模型就沒有理由去用。
- 全雙工要追上串接式系統NVIDIA 最近發表了以 Moshi 為基礎的模型,對話很流暢,但沒有 tool call、無法觀測。Neil 認為全雙工模型要先有串接式系統的可靠度、智慧與個人化,才取代得了它。
- 規模:成本幾乎都花在 TTS聲音很貴,大型業者的語音模式是虧錢在跑,消費型 app 的帳單主要是 TTS。
- 隱私與裝置端 TTS越私密的資料越希望留在本機。Gradium Phonon 能在手機 CPU 上跑,Neil 放了示範並宣布開放私人 beta。
- 結論:voice 不是 commodityNeil 反對「語音已成大宗商品」的說法,認為這仍是科學與工程問題。
名詞
- Gradium
- Neil 的公司,只做語音模型的基礎積木,不做 orchestration 與特定產業應用
- Moshi
- 他們在非營利實驗室時期做出的模型,Neil 說它是第一個對話用的 speech-to-speech 模型,至今仍是唯一的全雙工模型
- Gradium Phonon
- 裝置端 TTS,在手機 CPU 上跑,開放私人 beta
- cascaded system
- speech-to-text、LLM、text-to-speech 三段串接的傳統架構
- half-duplex / full duplex
- 半雙工是模型一次只能聽或說;全雙工能邊聽邊說,可處理重疊與附和
- backchanneling
- 對方說話時的附和聲,Neil 說在日文裡是禮貌與認真聆聽的表現
- semantic VAD
- Neil 列為他們串接系統的標配元件之一,沒有進一步說明