AI Engineer Europe 2026 · 演講 · 2026-05-10 · 16 分
擺脫 context 視窗的三個教訓
How we solved Context Management in Agents · Sally-Ann Delucia
Arize 的產品負責人 Sally-Ann Delucia 講他們的 agent Alex 怎麼走出 context 越塞越滿的死循環:截斷加記憶、長對話評估、拆出子 agent,以及還沒解決的部分。
概要
- context 管理是產品問題Sally-Ann 認為 context 不只是塞進視窗的量,而是策略性地挑模型該看什麼;agent 拿不到對的資料就會給爛答案,沒人會想用。
- 自己用自己的惡性循環團隊用 Alex 來分析 trace 與 span 資料,資料越長越撞到 context 上限,Alex 失敗後重試又加更多資料,繼續失敗。
- 兩種做法先後被放棄一開始只留前 100 個字元,後續追問就像全新對話;改用 LLM 摘要,又因為重點由模型自己決定,結果不穩。
- 現行方案是截斷加記憶保留頭尾各 100 個字元,中間存進記憶,Alex 需要時可以回頭取;Sally-Ann 說這幾個月沒再動過。
- 長對話要有自己的評估使用者不愛開新對話,問題往往到很後面才浮現,所以他們做了 long session evals,讓這類 bug 可以測。
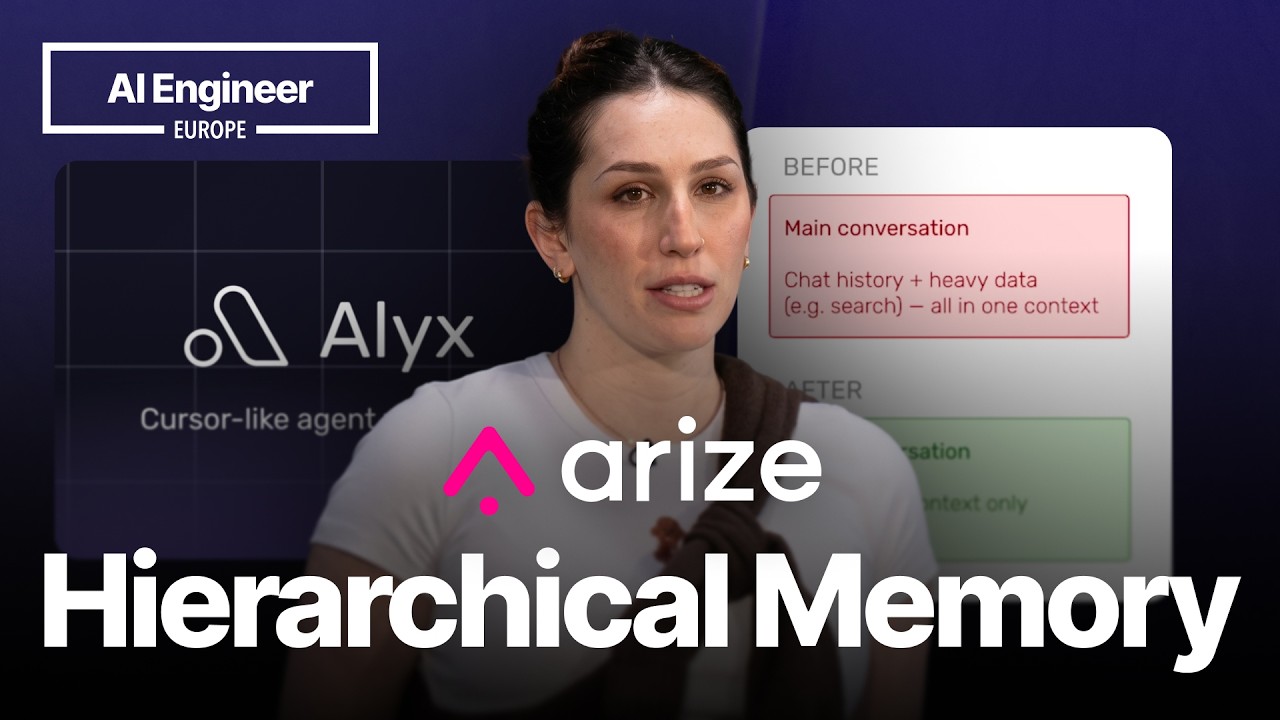
- 重活丟給子 agent搜尋 trace 要跑很多查詢與中間推理,這些放在子 agent 裡,主對話只留聊天內容,維持輕量。
原話
▶ 03:29“context management is a product in a ux problem not just an engineering one”
context 管理是產品與 UX 問題,不只是工程問題
▶ 07:47“So context decides what the model sees, memory decides what survives”
context 決定模型看到什麼,記憶決定什麼留得下來
▶ 10:51“I think I was surprised the most by the fact that summarization didn't work.”
我想最讓我意外的,是摘要沒用
▶ 13:00“We don't really have a principled context budget or clear metrics for context quality yet.”
我們還沒有原則性的 context 預算,也沒有明確的 context 品質指標
延伸
- Sally-Ann 說 Alex 有 40 個以上的內建 skill,涵蓋 prompt optimization、data gen 等流程,但這場沒有展開。
- 長期記憶還在開發中,Sally-Ann 只說目前的記憶只是 context 的儲存區,沒有講設計。
章節
點時碼直接跳到原片的那一段。
- Sally-Ann 與 AlexSally-Ann 是 Arize 的 head of product,也是 Alex 的核心貢獻者;Alex 是協助打造 AI 應用的 harness,這場講 context 的經驗。
- 從 prompt 到 context去年中起 context engineering 這個詞流行起來,Sally-Ann 舉 Andrej Karpathy 在 X 上的貼文,說大家發現決定 agent 成敗的是 context 而不只是 prompt,並認為好策略要讓 agent 記得該記的、忘掉不用的。
- Alex 面對的資料量Alex 跑在 Arize 的 observability 平台上,單一 trace 就很大,跨多個 trace 找規律只會更大,所以 context 策略不能省。
- 惡性循環用 Alex 開發 Alex,span 變長就撞上限而失敗,重試又加資料;分析資料的系統被資料本身卡住。
- 三個解法與粗暴截斷Sally-Ann 先預告三件事:控制 context、把 context 與記憶分開、把重活移到別的 agent;第一招是只取前 100 個字元,結果 agent 什麼都忘。
- 摘要也行不通讓 LLM 摘要聽起來合理,但誰重要由模型決定、無從控制,結果不可靠。
- 智慧截斷加記憶取頭尾各 100 個字元、中間存進記憶,重複訊息與冗長的 tool call 只留最新結果,system prompt 不重設,Alex 可自己回頭取回。
- 長對話與評估使用者習慣待在同一個對話裡,失敗到很後面才出現;long session evals 讓這類問題不必等使用者回報。
- 子 agent 分工搜尋任務一條 trace 可能有上百個 span,中間推理很多,Sally-Ann 說這些不必放在主對話,改交給子 agent。
- 還沒解決:超大輸入Sally-Ann 最意外的是摘要沒用;目前很大的 prompt 或輸入仍會撞到供應商的上限,他們持續靠拆子 agent 處理。
- 還沒解決:長期記憶對話從不到 10 輪長到 20 輪以上,Alex 目前沒有真正的長期記憶,工程師正在補。
- context 選擇仍是經驗法則留什麼只靠頭 100 加尾 100,沒有原則性的 context 預算或品質指標;Sally-Ann 也提到 Claude Code 的做法跟他們類似。
- 收尾三點context engineering、memory、evaluation 這三件事是 Sally-Ann 要大家帶走的。
- Q&A:cache有聽眾問有沒有顧到 cache 不失效;Sally-Ann 說目前先做長期記憶,用資料庫存 ID 加預覽,以後會再投入。
名詞
- Alex
- Arize 做的 AI harness,協助打造 AI 應用,Sally-Ann 是核心貢獻者,這場的案例主角
- Arize
- Sally-Ann 任職的公司,Alex 建在它的 observability 平台上
- trace / span
- Alex 要分析的 agent 資料單位,一條 trace 底下可能有上百個 span
- smart truncation memory
- 取頭尾各 100 個字元、中間存進記憶供回頭取用的現行方案
- long session evals
- 針對長對話後段才出現的遺忘問題做的評估
- sub-agent
- 承接資料量大的搜尋工作,讓主對話保持輕量