AI Engineer Europe 2026 · 演講 · 2026-06-09 · 11 分
RAG 沒死,只是變成多步檢索
RAG is dead, right?? · Kuba Rogut,Turbopuffer
Kuba Rogut 反駁「RAG 已死」的說法,主張檢索沒消失,而是變成 agent 手上一組可反覆呼叫的工具,並以 Cursor 與 Claude Code 的做法對照。
概要
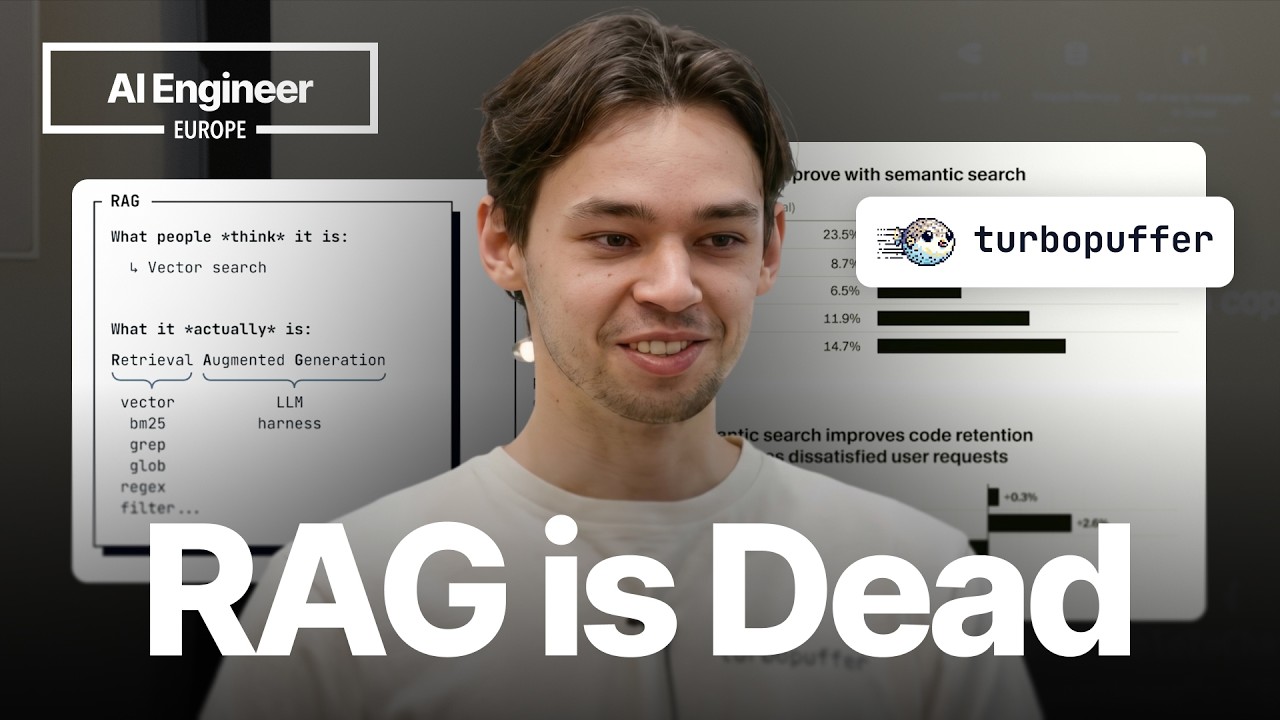
- 重新定義 RAG 與 agentic searchKuba 說多數人把 RAG 想成單純的向量搜尋,Turbopuffer 則認為檢索還包含全文檢索(BM25)、grep、glob、regex 與基本過濾;agentic search 則定義成給 agent 一組工具,讓它逐步、反覆地找出並推理上下文。
- Cursor 把程式碼庫先索引起來Cursor 在開啟程式碼庫時會切塊並嵌入,供語意搜尋使用。Kuba 轉述他們的部落格,說團隊裡的人大多在看同一份程式碼庫,所以用 Merkle tree 比對,只重新處理有變動的檔案。
- 語意搜尋有可量到的好處照 Kuba 的轉述,Cursor 內部基準測試中各模型的答案準確率平均提升約 12.5% 或 13.5%,Composer 模型則近 24%。線上 A/B 測試的數字看起來較小,原因是並非每個查詢都用得到語意搜尋。
- 嵌入是「快取起來的運算」Claude Code 每個 session 都要重新 grep、讀檔、判斷,Cursor 則先付一次索引成本,執行時用輕量工具查詢。Kuba 認為後者省 token、省時間、省錢。
- 檢索從一次呼叫變成迴圈Kuba 觀察到比較進階的客戶已在做 agentic search,agent 會做大量呼叫,依需要混用語意與全文搜尋,只取回當下需要的內容。
原話
▶ 02:45“it's really giving the agents a set of tools to kind of progressively and iteratively find and reason over context.”
其實是給 agent 一組工具,讓它逐步、反覆地找出並推理上下文。這是 Kuba 對 agentic search 的定義
▶ 06:30“embeddings and semantic search are kind of cache compute.”
嵌入與語意搜尋算是一種快取起來的運算。Kuba 說這是 Turbopuffer 內部的想法
▶ 09:28“retrieval is no longer just this simple one-time call to VectorDB.”
檢索不再只是對向量資料庫的一次簡單呼叫
▶ 10:18“you don't need a trillion at once, you need the right million.”
你不需要一次塞進一兆,你需要的是對的那一百萬。這句是 Kuba 轉述 Jeff Dean 的話
延伸
- Kuba 說有客戶在 Turbopuffer 裡嵌入了數兆個 token,重點是縮到對的一百萬再放進上下文視窗。
- Kuba 解釋 Cursor 為什麼要重用索引:一個 100 人的團隊多半只在一兩個程式碼庫上工作,每次都重新切塊、嵌入、上傳很貴。
章節
點時碼直接跳到原片的那一段。
- 破題:RAG 死了嗎Kuba 說這場要談混合式、工具豐富的檢索如何成為嚴肅 agentic search 的預設做法。
- 推文與搜尋量去年底到今年初很多推文說 RAG 已死,但 Kuba 指出 Google 搜尋量在 2025 年中之後反而大幅上升。
- 先釐清兩個詞Kuba 說多數人把 RAG 等同向量搜尋,Turbopuffer 的看法是檢索包含向量、全文、grep、glob、regex 與過濾。
- agentic search 的定義一般人講的 agentic search 是對檔案系統做 grep,Kuba 的定義是給 agent 一組工具,逐步找出並推理上下文。
- Cursor 如何索引程式碼庫Cursor 開啟程式碼庫就切塊、嵌入,並用 Merkle tree 在同團隊間重用資料,只更新有變動的檔案。
- 語意搜尋帶來的數字Kuba 轉述 Cursor 的準確率提升與線上 A/B 測試結果,並解釋後者數字小是因為不是每個查詢都需要語意搜尋。
- Claude Code 不用向量搜尋Kuba 轉述 Boris Cherny 的推文,說早期 Claude Code 用過本地向量資料庫,但效果不好。
- 嵌入是快取起來的運算Kuba 說 Turbopuffer 內部的想法是,嵌入與語意搜尋可以看成快取起來的運算。
- Claude Code 式的逐 session 探索要 agent 理解 metadata filtering 時,它得 grep、讀、評估再重複,每個 session 都重來一次,那一步約 6,000 個 token。
- Cursor 式的前期索引先付一次索引成本,執行時用輕量工具查詢,Kuba 說更省 token、時間與金錢,團隊裡有 Claude Code 使用者因此轉用 Cursor。
- 從 RAG 到 agentic retrievalKuba 認為單次向量搜尋丟進上下文的做法屬於 2023 年,進階客戶現在做的是多步檢索。
- Jeff Dean 的說法與結語Kuba 引用 Jeff Dean 的話,說重點是把數兆 token 縮到對的一百萬,之後開放提問。
名詞
- Turbopuffer
- Kuba 任職的公司,Cursor 是它的客戶之一
- RAG
- 檢索增強生成,Kuba 的拆法是「檢索」加上「把結果交給 LLM 生成」,檢索不限於向量搜尋
- agentic search
- 常被等同於對檔案系統 grep,Kuba 的定義是給 agent 一組工具逐步找出並推理上下文
- BM25
- Kuba 舉例的全文檢索方法,與 grep、glob、regex 同屬檢索手段
- Merkle tree
- Cursor 用來比對不同使用者程式碼庫差異的雜湊樹,只重新處理有變動的檔案
- Cursor
- 被 Kuba 當作 agentic search 做得好的例子,開啟程式碼庫時會先嵌入以供語意搜尋
- Composer
- Kuba 提到的 Cursor 自家模型,後來還有 Composer 2
- Claude Code
- 逐 session 用 grep 探索程式碼庫的例子,Kuba 說它不用向量搜尋
- Boris Cherny
- Kuba 稱為 Claude Code 的奠基者,轉述的推文說早期 Claude Code 試過本地向量資料庫,效果不好
- Jeff Dean
- Kuba 轉述了 Jeff Dean 談大上下文視窗與分階段檢索的說法