AI Engineer Europe 2026 · 演講 · 2026-04-20 · 11 分
用 MLX 在 iPhone 上跑 Gemma 4
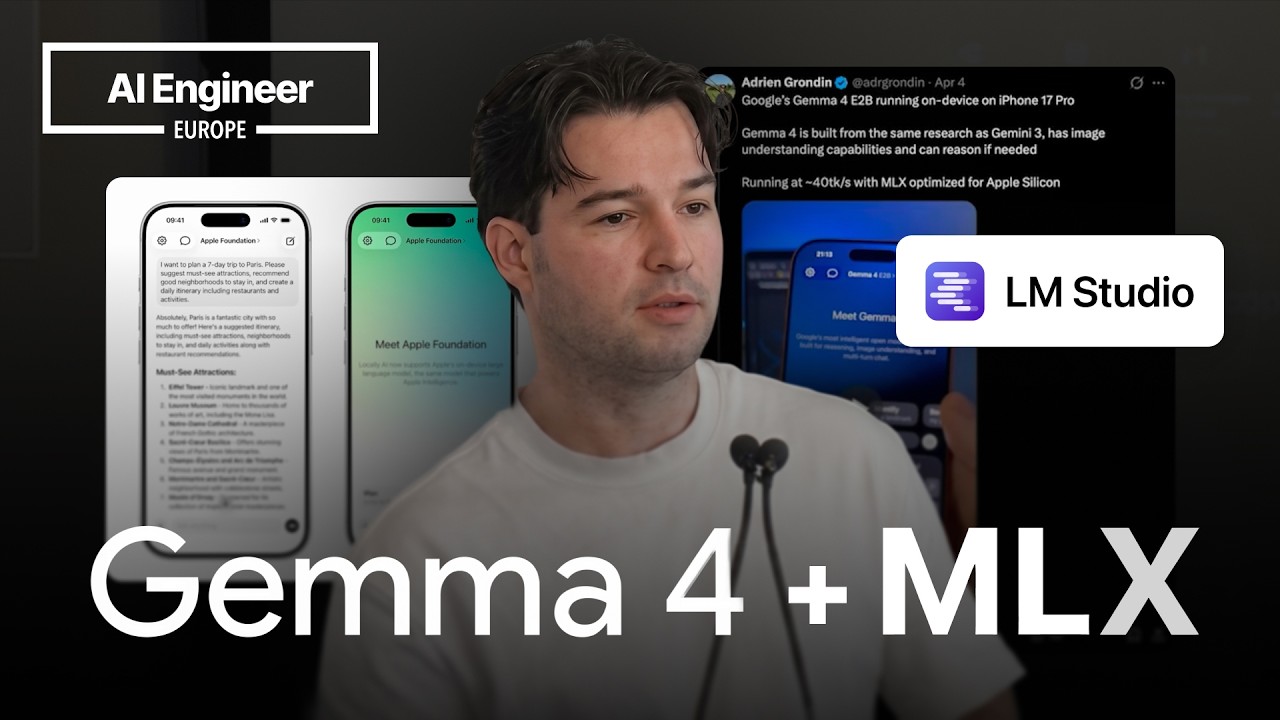
Running LLMs on your iPhone: 40 tok/s Gemma 4 with MLX · Adrien Grondin,Locally AI
Adrien 示範怎麼用 MLX 把 Gemma 4 這類小模型塞進 iPhone:套件怎麼裝、權重去哪拿、量化挑幾位元,還有實測的速度。
概要
- 套件一個就夠Adrien 說在 iOS、macOS、iPadOS 上,裝 mlx-swift-lm 就能下載並執行模型,API 很單純,不到 10 分鐘就能做出一個跑本機模型的 app。
- 權重去 Hugging Face 的 MLX community 拿那裡有量化好的各種版本,Adrien 說有將近 4000 到 5000 個模型,新模型發表後差不多 30 分鐘就會有人上傳。
- 量化位元的取捨手機上要選量化版,Adrien 建議落在 4-bit 到 8-bit,4-bit 以下輸出明顯受影響,模型通常就不太好用了。
- 速度實測最新的 iPhone 上,4-bit 的 Gemma 4 能輕鬆跑到每秒 40 tokens;舊款 iPhone 到不了這個速度,但 Adrien 說每秒 20 tokens 也已經很有用。
- 小模型有小模型的用法Adrien 的 app 裡有 Liquid 的模型,小到可以在 Shortcuts 裡跑,拿來做文字處理等自動化。
- 目前的門檻是模型體積下載一個模型通常是 1 GB 或 3 GB,Adrien 認為這是最大的障礙,但模型變小變聰明、手機也在進步。
原話
▶ 01:19“It's really fast, it runs really well on MLX”
很快,在 MLX 上跑得很順
▶ 05:03“Usually, under 4-bit, it's starting to get a lot of impact on the output.”
通常低於 4-bit,輸出就開始受到很大影響
▶ 06:46“even if you get 20 tokens per second, that's already great”
就算只有每秒 20 tokens,也已經很不錯
▶ 07:18“that's the biggest barrier right now”
那是現在最大的障礙,Adrien 指的是模型的體積
延伸
- Adrien 提到有些套件建在 mlx-swift-lm 之上,試著補上結構化生成,但沒有說是哪些。
- Adrien 介紹 LM Studio 時提到,它能在本機開 server,回應格式可以選 OpenAI 或 Anthropic 那一種,讓自己的應用程式直接接上本機模型。
章節
點時碼直接跳到原片的那一段。
- 開場這場要示範怎麼用 MLX 在 iPhone 上跑 Gemma 4。
- Adrien 與 Locally AIAdrien 是 Locally AI 的開發者,這個 app 是純原生的聊天工具,用 MLX 在 iPhone 上跑本機模型,也能接 Apple Foundation。
- Gemma 4 與 MLXGemma 4 有多個尺寸,較小的能在 iPhone 上跑;MLX 是 Apple 為 Apple Silicon 做的框架,app 也支援 iPad 與 macOS。
- 用 mlx-swift-lm 接進 app除了 Gemma,Qwen 和 SmolLM 也能跑;到 GitHub 的 mlx-swift-lm 下載模型並執行,API 簡單。
- MLX 生態系做 Python 或 macOS app 可以用 mlx-vlm,另有 mlx-audio 與 mlx-video,生態系越長越大。
- 去哪裡拿模型在 Hugging Face 的 MLX community 找量化權重,拿到 ID 後交給框架,就會直接下載。
- 量化位元怎麼挑iPhone 上要選量化版;Adrien 的經驗是 4-bit 到 8-bit,低於 4-bit 輸出品質掉得明顯。
- 小模型用在捷徑自動化Adrien 的 app 也放了 Liquid 的小模型,速度夠快,能在 Shortcuts 裡做文字處理一類的自動化。
- 每秒 40 tokens 的現場 demo最新 iPhone 上 4-bit 的 Gemma 4 輕鬆跑到每秒 40 tokens,Adrien 放影片示範離線串流輸出。
- 舊款 iPhone 與下載門檻舊款機型達不到每秒 40 tokens,但每秒 20 tokens 仍然可用;最大的障礙是模型的下載體積。
- 模型與手機都在進步模型越來越小也越來越聰明,加上新的 iPhone,Adrien 認為可用性正在到位。
- Locally AI 被 LM Studio 收購Adrien 說前一天傳出 Locally AI 被 LM Studio 收購;這個工具可下載模型、用 llama.cpp 或 MLX 跑,還能開本機 server。
- Q&A:tool callingmlx-swift-lm 支援 tool calling,自訂與結構化生成還沒有;模型的 tool calling 也比一年前好很多。
名詞
- Locally AI
- Adrien 開發的 app,在 iPhone、iPad 與 macOS 上以原生方式跑本機模型
- MLX
- Apple 做的框架,針對 Apple Silicon 最佳化,也就是 iPhone 與 Mac 的晶片
- mlx-swift-lm
- GitHub 上的 repo,給 iOS、macOS、iPadOS app 下載並執行模型
- mlx-vlm
- 給 Python 或 macOS app 跑視覺語言模型的專案
- MLX community
- Hugging Face 上放 MLX 量化權重的社群,模型發表後很快就有人上傳
- Gemma 4
- 這場示範的主角,較小的尺寸能在 iPhone 上跑
- Liquid
- Adrien 的 app 裡也放了這家的小模型,小到能在 Shortcuts 裡跑
- LM Studio
- 管理並執行本機模型的工具,可用 llama.cpp 或 MLX,也能開本機 server;Locally AI 被它收購