AI Engineer Europe 2026 · 工作坊 · 2026-05-18 · 76 分
讓 agent 連跑數小時的 harness
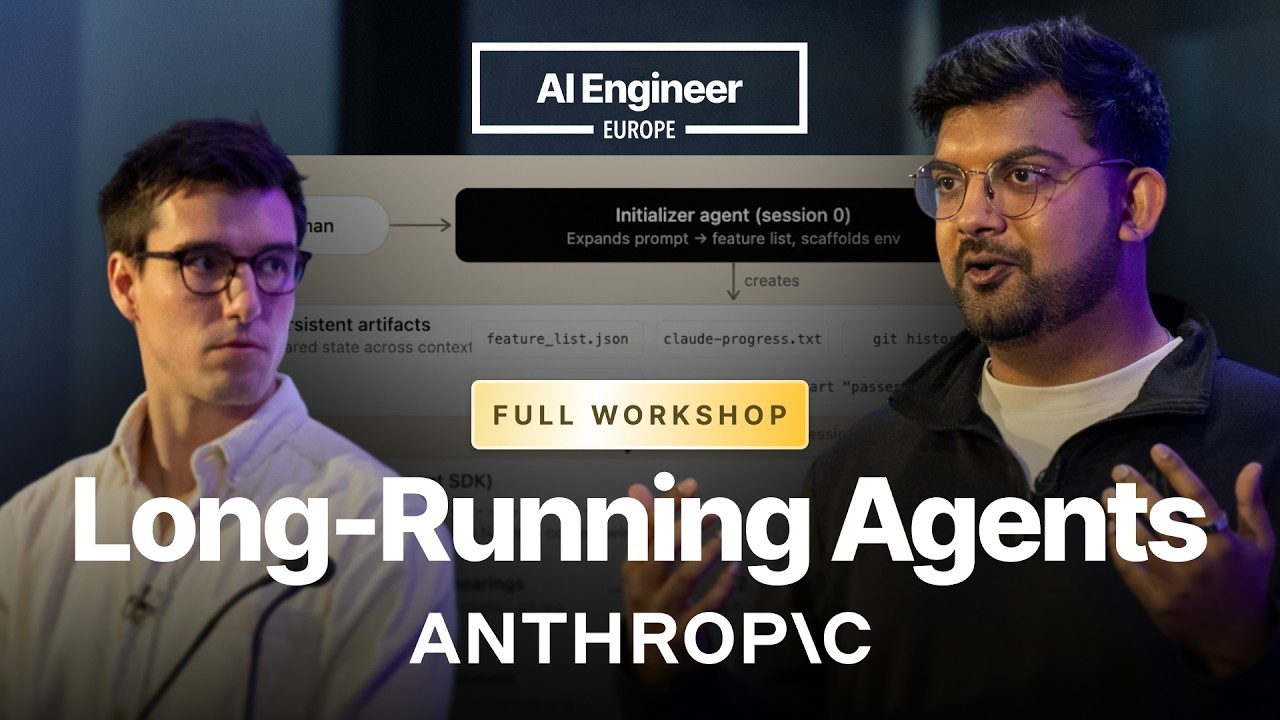
Anthropic Workshop: Build Agents That Run for Hours · Ash Prabaker、Andrew Wilson
Andrew 先回顧一年來讓 agent 跑得更久的功能演進,Ash 再拆解 planner、generator、evaluator 三角色的 harness,最後是一整段 Q&A。
概要
- 長時間執行卡在三件事Andrew 把困難分成 context、planning 與自我評估。context 有限、會 rot,模型也不擅長規劃;還指出模型很不會評斷自己的產出,容易覺得做得差不多了就往下走。
- 模型與 harness 一起演進Andrew 的回顧裡,每次模型發表,Claude Code 與 Claude Agent SDK 也跟著釋出新的 harness 功能。展示的圖顯示,最小 scaffold 下的可執行時間從約 1 小時拉到 12 小時,但 harness 不會跟著消失,而是隨模型改變。
- 用獨立的 evaluator 取代自我檢查Ash 的做法借 GAN 的對抗概念,把 generator 與 evaluator 拆成各自的 context 與 system prompt,evaluator 用 Playwright 實際操作頁面再回饋批評。理由是把獨立的 critic 調嚴格很可行,要 builder 對自己嚴格則不然。
- planner 只寫高層 spec,細節靠 contractplanner 把一句話的需求拆成數個 sprint,不碰技術細節,以免錯誤在多小時的流程裡層層放大。generator 與 evaluator 動工前先協商「做完」的定義,透過磁碟上的檔案來回,之後 evaluator 以這份 contract 打分。
- 同一個 prompt,有無 harness 差很多Ash 用「build a retro game maker」對照單一 loop 與完整 harness,後者約花 200 美元、6 小時,play mode 真的能動;並說兩者的差別完全來自 scaffolding。
- harness 要隨模型簡化Ash 說從 Opus 4.5 到 Opus 4.6,context 重置與 sprint 拆解都能拿掉,evaluator 也從每個 sprint 跑一次改成最後跑一次,planner、generator、evaluator 的核心留著。Q&A 另外談到信任、重來、brownfield 的適用範圍與讀 trace 的重要。
原話
▶ 16:35“the harness doesn't just disappear as the models get better, it's really evolving as the models change over time”
模型變好,harness 不會就此消失,而是隨模型改變
▶ 19:57“tuning a standalone critic to be harsh is actually very tractable. But tuning a builder to be somewhat self-critical is not.”
把獨立的 critic 調嚴格其實很可行,要 builder 對自己有些批判則不然
▶ 35:47“The lesson isn't necessarily our harness was wrong, but rather it was right for 4.5, the frontier moved”
教訓不是 harness 錯了,而是它對 4.5 是對的,前沿已經移動
▶ 38:58“self-evaluation very much a trap just use an adversarial evaluator”
自我評估很容易是陷阱,直接用對抗式的 evaluator
▶ 1:13:25“I do think it's like a really important skill when building agents in general, is to, like, empathize as much with the model.”
我認為做 agent 很重要的一項技能,就是盡量對模型感同身受
延伸
- 第一代 harness 把 feature list 存成 JSON,因為他們發現模型容易覆寫 markdown 檔,卻比較不會去改 JSON;Q&A 裡也有一位講者說,自己會讓 agent 把學到的東西與狀態寫進 JSON,留給下一個模型或人接手。
- Andrew 轉述 Ralph loop 背後的想法:可預期地失敗,比不可預期地成功好。
- Ash 說拿掉 context 重置的原因是 Opus 4.5 有很嚴重的 context anxiety,Opus 4.6 經過 post-training 就沒有這個問題。
- 讀 trace 那題的回答舉了做瀏覽器操作 harness 時的練習:閉著眼睛操作網頁,每 10 秒睜眼看一次靜態畫面,體會模型的處境。
- Ash 也承認,超長時間執行的 agent 要怎麼做 observability,目前還沒有解決。
章節
點時碼直接跳到原片的那一段。
- 開場與分工Ash 與 Andrew 自我介紹,說明主題源自 Anthropic 幾週前的一篇部落格,Andrew 先講演進,Ash 再講實驗中的 harness 與案例。
- 長時間執行為什麼難Andrew 把問題分成三類:context 有限與 context rot、模型不擅長規劃、模型很不會判斷自己的產出。
- 改模型,還是改 harness先看最小 scaffold 下的可執行時間圖,再介紹 Claude Agent SDK 內建的 sub-agent、MCP、CLAUDE.md、skills 等 primitives。
- Claude Code 的起點回顧 Sonnet 3.5 的 artifact、computer use、MCP,到 2025 年 2 月 Claude Code 以 research preview 登場,再到 Opus 4 與 Sonnet 4 時期 GA 並推出 SDK。
- Ralph Wiggum 技術把同一個 prompt 丟進 loop 直到任務完成;Andrew 解釋官方 plugin 靠 stop hook 與 compaction 達成,不是每次都換新的 context window。
- Sonnet 4.5 到 Opus 4.5模型開始能感知 token 用量,Claude Code 2.0 加入 checkpoints,SDK 改名為 Claude Agent SDK;skills 與 programmatic tool calling 用來省 context。
- 第一代長時間 harness去年 11 月的部落格做法:initializer agent 產生 feature list、progress file 與 init script,之後每輪在新 context 只做一個功能並驗證。
- Opus 4.6 與歷史收尾Opus 4.6 很 agentic,agent teams、server-side compaction 與 1M context GA 出現;Andrew 總結 harness 隨模型一起演進。
- Generator 與 evaluatorAsh 接手,介紹借自 GAN 的對抗式設計:兩個角色分開 context,evaluator 用 Playwright 實際操作而不只是讀 diff。
- 把品味寫成 rubric用 design、originality、craft、functionality 四項打分,目的是避開紫色漸層之類的 AI slop 風格;卡關時整個重來而不是原地修補。
- Planner 與 contract加入只寫高層 spec 的 planner,generator 與 evaluator 開工前先協商驗收條件,之後 evaluator 照 contract 打分,這是 Ralph loop 沒有的部分。
- Retro game maker 對照同一個 prompt、同一個模型:單一 loop 的 play mode 按鍵沒反應,加上 harness 後約 200 美元、6 小時,做出 Retroforge。
- Evaluator 抓到什麼與調校evaluator 抓到過 API 路由順序與刪除鍵邏輯等只有實際操作才發現的錯;這次有 27 條 contract 標準,調校主要靠讀 trace。
- 隨模型簡化 harness拿掉 context 重置、sprint 拆解與每個 sprint 都跑 evaluator,保留 planner、generator、evaluator;成本約為先前的一半,示範做出 DAW。
- 可以帶走的五件事列出現成工具:auto mode、自訂 sub-agent、Playwright MCP、skills;再整理五個結論,從自評是陷阱到何時刪掉 scaffold。
- Q&A:evaluator 重用與 smart zone有聽眾問調校成果能否跨專案重用,回答是目標在抓模型的共通弱點;接著被問是否還要把任務切到小 context,Andrew 說 4.6 之後改成單一長 session 加 compaction,仍看用途與 eval。
- Q&A:Playwright 與信任有聽眾想看著模型操作瀏覽器並介入;其中一位講者認為重點是建立信任後放手,並說 Opus 4.6 讀網路與 console 錯誤已經可靠。
- Q&A:重來與人工介入有聽眾問 evaluator 會不會不管就放行;其中一位講者說模型願意在跑了多輪後整個丟掉重來,也可以用 hooks 插入人工。
- Q&A:planner 要不要回頭說明 spec 會在 session 中反覆放進去當參照,但 planner 不參與迴圈;這個對抗式組合也能放進多步驟 workflow。
- Q&A:模型選擇與長期產品Andrew 說模型選擇會影響 harness 設計,並提到用 Opus 做規劃、Sonnet 做執行;其中一位講者說明用檔案系統與 JSON 留下給下一個模型或人的紀錄。
- Q&A:agent teams 與 generator-criticAndrew 說 Claude Code 與 Claude Agent SDK 同一套 harness,能做這個模式;Ash 把它看成 agent teams 的子集。
- Q&A:critic 看不看 context、trace 怎麼追其中一位講者不建議讓 critic 拿到 generator 的推理,只要指出問題;追蹤 trace 主要靠手動閱讀,加上用 Claude 先做第一輪整理。
- Q&A:怎麼衡量好壞靠逐項 rubric 與前後分數在同一個產品內比較,不同產品之間不好比;這套做法偏 greenfield 且帶有固定技術選擇。
- Q&A:團隊協作與人工審查Ash 承認團隊共用 harness 還沒有好工具,只能靠最初提出的人維護,Andrew 補充可以先靠版本控制與 git worktree;被問到 sprint review 時,其中一位講者說目標是盡量不放人進迴圈。
- Q&A:brownfield 的用法Andrew 說這個模式主要用在 greenfield;brownfield 需要自己的 rubric 與更多控制,另外也談到把監控、issue、PR 串起來的做法。
- Q&A:讀 trace 與換位思考要完整讀 trace、站在模型的位置想,再把學到的寫進 prompt、CLAUDE.md 或 skill。
名詞
- harness
- 包在模型外面的 scaffolding,這場講的是怎麼設計它來支撐長時間執行
- Ralph Wiggum technique
- 把同一個 prompt 在 loop 裡反覆跑到任務完成;官方 plugin 用 stop hook 攔截停止並繼續
- generator / evaluator
- 兩個各自有 context 與 system prompt 的角色,一個負責建、一個負責用 Playwright 實際操作並批評
- planner
- 把一行需求拆成高層 spec 與 sprint,刻意不規劃技術細節
- contract
- 動工前由 generator 與 evaluator 協商的驗收條件,之後 evaluator 照它打分
- context rot
- 在 context window 越用越深時,連貫性下降
- context anxiety
- 模型接近 context 上限時變得急躁,匆忙收尾
- Claude Agent SDK
- 由 Claude Code SDK 改名,包含 sub-agent、MCP、skills 等 primitives,用來自建 harness
- agent teams
- Claude Code 的功能,sub-agent 之間可以互相溝通,必要時才回報主 agent
- Retroforge
- retro game maker 示範中,帶 harness 的那次跑出來的 app 名稱