AI Engineer Europe 2026 · 演講 · 2026-05-31 · 15 分
分數很高的模型,寫出來的程式能上線嗎
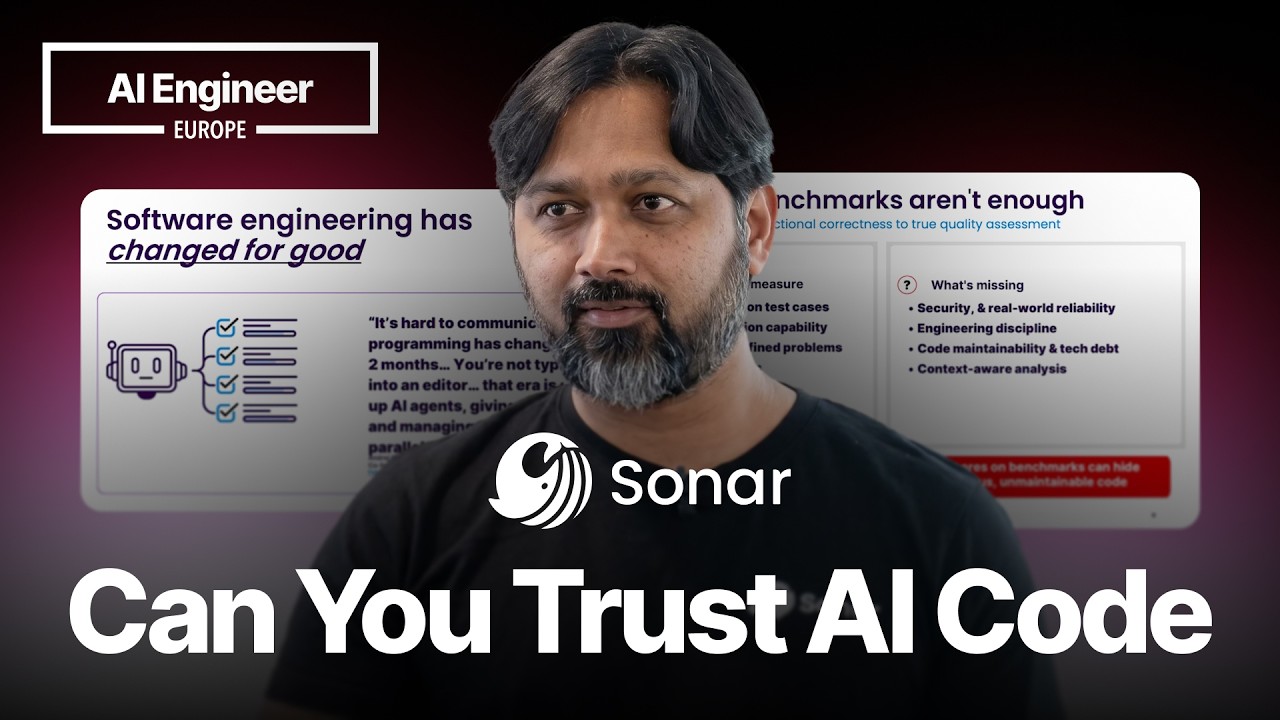
Can LLMs generate Enterprise Quality Code? · Prasenjit Sarkar,Sonar
Sonar 拿 4,000 多題 Java 題目量了 53 個以上的模型,發現通過率高的模型常常寫得又長又多 bug,並提出引導、驗證、修補三階段的做法。
概要
- 基準分數只看功能對不對Prasenjit 說各家模型都在報 80% 以上的通過率,但那只驗功能正確性,安全、可靠度、可維護性、技術債這些都沒被量到。
- 模型越新,程式碼越長同一批 Java 題目,Gemini 3.1 Pro High 產出 307,000 行,Claude Sonnet 4.6 是 627,000 行,GPT-5.4 與 GPT-5.4 Pro High 到 1.2 million 行。Prasenjit 也說越新的模型行數越往上走,複雜度與 bug 總數也跟著升高。
- 問題換了種類,沒有消失Prasenjit 的觀察是成熟的模型靠強化學習擋掉了舊型的問題,漏洞總數在下降,但留下的是更細微、人更難看出來的 bug 與漏洞。
- 成因有好幾個訓練資料品質參差、內建安全缺陷、藏著細微的邏輯錯誤,加上 LLM 本身是機率性的、看不到公司的程式碼庫與架構、也無法解釋自己為什麼這樣寫。
- Sonar 的 ACDC 流程分 guide、verify、solve 三個階段,另有 inner loop 與 outer loop。
- 在 commit 之前就驗verify 階段讓 agent 寫完程式、還沒 commit 就先分析,約需 1 到 5 秒,CI 要跑 1 到 5 分鐘;solve 階段的修補 agent 會把有問題的修正丟掉,不交出會造成 regression 的程式。
原話
▶ 00:55“English is now the new programming language everybody's talking about”
英文成了大家都在講的新程式語言
▶ 01:32“do you trust the code that is being generated by these LLMs, right?”
你信任這些 LLM 產出的程式碼嗎
▶ 09:53“they are getting kind of finer bugs or finer security issues rather than the old issues”
成熟的模型留下的是更細的 bug 與安全問題,不是舊型的
▶ 13:46“the remediation agent is going to create the fix, run it through the analysis again, run it through the compilation part again”
修補 agent 產出修正後,會再跑一次分析與編譯
延伸
- 排行榜點進每個模型都有細部資料,Prasenjit 建議依自己的架構來挑模型。
- 通過率最高的 Gemini 3.1 Pro High,是 2 月 19 日評估的那一筆。
章節
點時碼直接跳到原片的那一段。
- 開場與題目Prasenjit 自我介紹,這場要問的是 LLM 產出的程式碼到底能不能直接用在企業環境。
- 開發方式的轉變從在 IDE 裡寫程式,變成啟動 agent、用英文下指令,由人類審查 agent 產出的程式碼;Prasenjit 也問聽眾信不信這些程式碼可維護、安全、好讀。
- 基準測試漏掉什麼各家報的通過率是 80% 以上,只驗功能正確性;安全、可靠度、架構、可維護性、技術債與 context 分析都沒被量到。
- Sonar 的評估框架用公開的 Java 題目資料集跑各個模型,再用 SonarQube Enterprise 分析,結果也公開放出。
- 幾個模型的實測數字Gemini 3.1 Pro High 通過率 84.17、307,000 行;Claude Sonnet 4.6 每百萬行 300 個安全問題、627,000 行;GPT-5.4 系列 1.2 million 行。
- 為什麼會這樣訓練資料品質參差、內建安全缺陷與隱藏 bug;LLM 是機率性的、context 有限、也無法解釋。
- 公開排行榜已評估 53 個以上的模型與各種 thinking 組合並全數公開;Gemini 3.1 Pro High 通過率最高,超過 80% 的有五個模型。
- 兩種複雜度cyclomatic complexity 數分支與迴圈;cognitive complexity 是 Sonar 自家的指標,衡量人要讀懂與維護有多費力。
- 新模型越寫越長GPT-5.2 High 產出超過一百萬行,早期的 GPT 模型少於 250,000 行;行數、複雜度、bug 總數一起上升,但漏洞總數在下降、種類變細。
- ACDC 框架agent-centric development cycle,分 guide、verify、solve 三階段,有 inner loop 與 outer loop。
- Guide:先把源頭顧好Sonar Sweep 處理訓練用的資料,Sonar Context Augmentation 把整個程式碼庫的 context 餵給 LLM。
- Verify:commit 前分析SonarQube Agentic Analysis 透過 MCP 接上 Claude、Codex、Gemini CLI,在 commit 之前分析,約 1 到 5 秒,CI 要 1 到 5 分鐘。
- Solve:修補 agentSonarQube remediation agent 修 PR 上的問題,也能對技術債每個問題各開一個 PR 交給開發者審查。
- 修正自己也要驗修補後再跑一次分析與編譯,有問題就丟掉;最後提到產品支援 40 種以上的語言與框架、DevOps 與 IDE。
名詞
- Sonar
- Prasenjit 任職的公司,這場報告的評估框架與工具都出自這裡
- SonarQube
- Sonar 的程式碼分析產品,這場用它的 Enterprise 版來分析各模型產出的程式碼
- cyclomatic complexity
- 數程式裡有幾個 if、for、while 等分支與迴圈的複雜度指標
- cognitive complexity
- Sonar 自家的指標,衡量人類讀懂並維護一段程式碼的難度
- ACDC
- agent-centric development cycle,Sonar 提出的 guide、verify、solve 三階段流程
- Sonar Sweep
- guide 階段的產品,處理用來訓練模型的資料,Prasenjit 說目前是 private beta
- Sonar Context Augmentation
- guide 階段的產品,把整個程式碼庫的 context 推進 LLM
- SonarQube Agentic Analysis
- verify 階段的產品,在 agent 寫完、commit 之前先分析,目前是 open beta
- SonarQube remediation agent
- solve 階段的產品,自動修 PR 上的問題與技術債,目前是 open beta