AI Engineer Europe 2026 · 演講 · 2026-06-02 · 21 分
任務品質高低,訓練成效差五倍
Task Fidelity Scaling Laws · Kobie Crawford,Snorkel
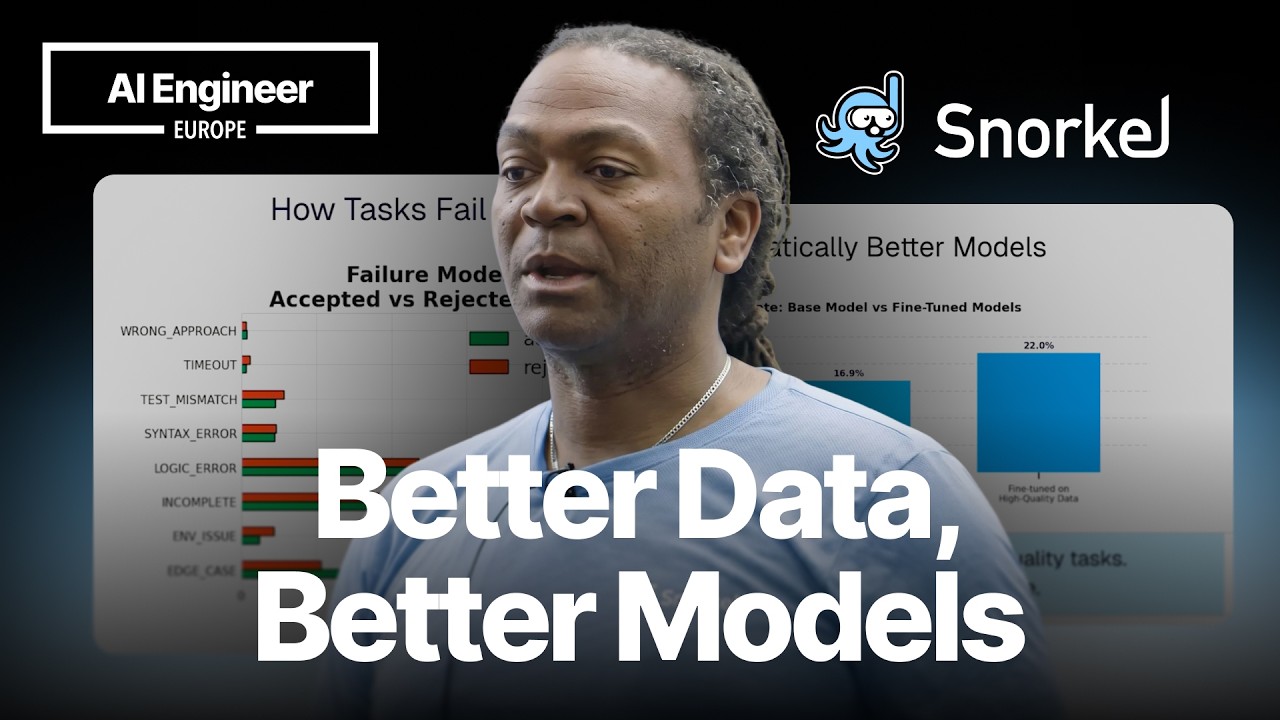
Snorkel 把 terminal bench 風格的 agent 任務分成通過與未通過驗收兩桶,各拿去做 RL 訓練,比較同一個模型的進步幅度。結果顯示資料品質對訓練成效的影響很大。
概要
- 資料品質是公司的核心主張Kobie Crawford 說 Snorkel 自 2019 年成立以來,一直認為資料品質至關重要。這場想用實驗驗證,任務品質是否真的會影響訓練結果。
- 四項驗收標準任務要能完成、不是太簡單、邏輯正確,而且環境穩定可靠。四項測試全過的任務算「accepted」,沒過的進「rejected」。
- 通過驗收的任務比較難Snorkel 用 Sonnet 4.5 與 Codex 跑這兩桶任務,accepted 任務的 tool call 平均多一倍,通過率較低,輸出的 token 也比較多。
- 失敗比較有意義Snorkel 把失敗分成模型真的沒做對,和環境問題讓任何模型都不可能做完兩類。Kobie 的結論是 accepted 任務產生的失敗比較「乾淨」,比較適合拿來讓模型練習。
- RL 訓練相差約五倍同一個模型、同樣的運算預算,低品質任務只讓基礎模型進步約 1%,高品質任務進步約 6%。
- Q&A 談到雜訊與評分被拒絕的任務常見問題是規格不清、測試藏有隱含依賴;評分上,Snorkel 用 rubric 讓人類標註者與 LLM judge 對照一致性。
原話
▶ 01:11“the core thesis has been that the quality of data is critical”
核心主張一直是資料品質至關重要
▶ 05:40“our accepted tasks averaged twice as many tool calls demonstrating more difficulty”
我們通過驗收的任務,tool call 平均多一倍,顯示難度更高
▶ 08:00“the accepted tasks are producing cleaner failures”
通過驗收的任務,產生的失敗比較乾淨
▶ 09:45“the improvement was about a six percent improvement with the higher quality tasks”
高品質任務帶來約 6% 的進步
▶ 10:25“the expert in the loop is an important element of delivering data quality”
專家參與是確保資料品質的重要一環
延伸
- Snorkel 的源頭是 Stanford 研究室的研究,原本是執行長博士論文的一部分,先成了開源函式庫,之後才轉向替客戶交付資料集。
- Kobie 承認架構與 harness 的改變也會影響結果,但 Snorkel 的立場是,這一切底下的核心仍然是資料品質。
- 談標註一致性時,Kobie 同意任務的時間跨度越長、步驟越多,評分就越難一致;在這次研究這種測試只有過或不過的領域,相對容易。
章節
點時碼直接跳到原片的那一段。
- 公司與核心主張Kobie 介紹 Snorkel 是替基礎模型產出訓練資料集的 Frontier AI Data Lab,起源於 Stanford 的研究室,從 2019 年起就主張資料品質最關鍵。
- 要驗證的問題這場想實證任務品質是否影響訓練結果,範圍限定在 terminal bench 風格的任務:容器化環境加上任務定義。
- 任務品質的四項標準環境容器化以確保可重現與隔離,也方便平行跑 rollout;任務要可完成、不簡單、邏輯正確,環境要可靠。
- 接受與拒絕兩桶四項測試全過的任務算 accepted,可用於訓練與研究,其餘進 rejected,兩桶拿來對比高低品質。
- 兩桶任務的表現差異用 Sonnet 4.5 與 Codex 跑任務,accepted 的 tool call 多一倍、通過率較低、輸出 token 較多。
- 失敗類型分類低通過率未必有訊號,所以把失敗分成模型沒達成邏輯結論,和環境問題導致任何模型都做不完。
- 失敗比例的對照在 logic error 與 incomplete task 兩類,兩桶的比例高低互換;accepted 任務的失敗比較乾淨,適合拿來訓練。
- RL 訓練結果同模型、同運算預算訓練兩次,低品質任務進步約 1%,高品質任務約 6%。
- 專家參與與結語Snorkel 產生資料與 RL 環境時有專家參與,Kobie 認為這是品質的重要一環,並呼籲把品質放在第一位。
- Q&A:公開基準的雜訊回答聽眾提問時,Kobie 說 Snorkel 內部比較過 terminal bench 一代與二代、SWE-bench 的幾個變體等公開基準,有些任務根本做不完,會掩蓋模型是否真的在進步。
- Q&A:被拒任務的特徵常見原因是任務規格沒寫清楚,但測試卻預期了沒被要求的結果,或藏著沒說明的隱含依賴。
- Q&A:可驗證與否Kobie 說做基準任務時會讓後端可驗證,並期待學到的技能能用在不可驗證或需要多輪迭代的情境。
- Q&A:難驗證領域程式和數學容易驗證,較模糊的領域較難;Snorkel 有開放的 benchmark grants 計畫,並談到讓多種結果在光譜上評分。
- Q&A:標註者一致性平台結合人類標註者與 LLM judge,用同一份 rubric 檢查人與人、LLM 與人之間的一致性,並用於品質評估。
名詞
- Snorkel
- Kobie Crawford 任職的公司,自稱 Frontier AI Data Lab,替基礎模型產出可以 hill climb 的資料集
- terminal bench
- 這場研究所用的任務風格:容器化環境加上任務定義,Kobie 也提到它的一代與二代
- Harbor Framework / OpenEnv
- Kobie 舉例的、用來建立評測與 RL 任務環境的框架
- accepted / rejected 任務
- 通過全部四項驗收測試的任務歸 accepted,沒通過的歸 rejected
- hill climb
- 模型靠資料集反覆改進分數,Snorkel 的資料集就是為此而做
- rollout
- 在容器化環境裡跑任務的一次嘗試,環境隔離後可以平行執行
- LLM judge
- 依 rubric 評分的語言模型,與人類標註者並用以擴大規模
- inter-annotator agreement
- 標註者之間評分的一致程度,Kobie 用它檢查人與人、LLM judge 與人的對照