AI Engineer Europe 2026 · 演講 · 2026-06-08 · 26 分
Context 越多 agent 越笨
Why More Context Makes Your Agent Dumber and What to Do About It · Nupur Sharma,Qodo
Nupur Sharma 從做 agentic code review 的經驗談起,說明 context 塞得越多,模型越抓不住重點,並整理 context 優化、80-20 混合做法,以及專家 agent 加 judge agent 的架構。
概要
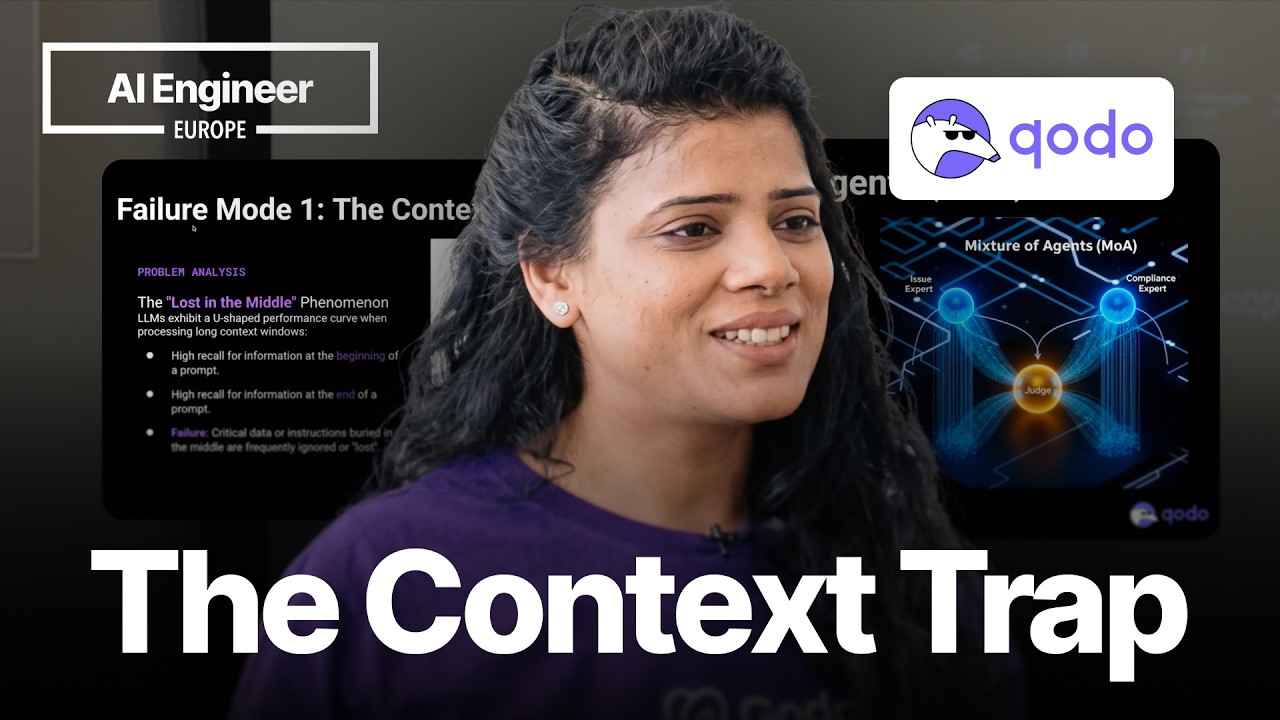
- Context 塞多不等於變聰明Nupur 觀察到模型會看開頭和結尾的輸入,夾在中間的內容容易被忽略,像一條 U 型曲線。就算整個 codebase 都給了,一開始設的目標和最後給的輸入還是最被注意。
- 先替模型整理 contextNupur 把做法分成 context engine、每個檔案與資料夾的摘要、knowledge graph、iterative retrieval 和自我修正,每一種都有各自的成本;多數不是做產品的情境,用 iterative retrieval 就夠。
- Orchestration paradox 與 80-20越聰明的模型越愛一直研究該用哪個方法,token 都花在找方法上。Nupur 的團隊讓 agent 在 80% 的工作自由研究,剩下 20% 的驗證與摘要用比較死的規則卡住。
- 別讓一個 agent 包辦所有事任務給多了,agent 會只顧其中幾件,其餘的在中途掉了。Nupur 主張拆成小的專家 agent,再用 judge agent 把各自的結果合起來看是否說得通。
- Qodo 的 code review 架構context collector 先收集 PR、context engine 和各種工具的資料,再分給 security 等專長 agent,最後由 judge agent 對照 PR 歷史與開發者過去的反應,決定哪些建議值得給。
- 回饋會變成權重開發者接受的建議,下次權重會提高,不接受的就降低;另外也用過去 PR 裡類似問題有沒有被修掉來調整。
原話
▶ 02:39“Context is not a problem, day by day the models are coming where you can dump a lot of context, a lot of data”
context 不是問題,模型一天比一天能讓你倒進大量 context、大量資料
▶ 09:27“it just goes into a loop of trying to do something rather than doing something”
它就陷進一個迴圈,一直試著要做事,卻沒有真的在做事
▶ 11:19“but you don't need a high reasoning model for the 20% because those 20% things are doing deterministic”
但那 20% 不需要高階推理模型,因為那些事是確定性的
▶ 13:20“We create small, small agents which are doing great in a specific task which they have provided.”
我們做很多小小的 agent,各自在被指派的特定任務上做得很好
▶ 24:42“if it does not accept the suggestion it gets a less weight”
開發者不接受的建議,權重就會變低
延伸
- Nupur 說醫療、零售、金融業都可能用同一套 Java 框架,但在意的東西各不相同,LLM 不知道對你來說什麼重要,所以要靠 PR 歷史與準則來校準。
- 規則和 bug 分開處理:寫成規則的,不管開發者想不想要都會被標出來;bug 類的建議如果 reviewer 也同意、卻十次都沒修,權重就會被調低。
章節
點時碼直接跳到原片的那一段。
- Nupur 的背景Nupur 在 Qodo 做 agentic review,從 DevSecOps 這種一切可預期的環境,轉到 agent 會以意想不到方式失敗的地方,這場分享自己學到的東西。
- agent 的演進從 4K context window 的靜態 prompt,到能搜尋的 agentic workflow,再到 multi-agent,每一步都帶來新問題,例如工具不知道何時停手、多個 agent 理解互相衝突。
- context 不是問題模型能吞很多 context,但不代表能判斷什麼重要;Nupur 說模型偏重開頭與結尾,中間的內容沒被採用,像 U 型曲線。
- context engineNupur 把 context engine 比成門口的 bouncer,替任務排出重要的內容;適合大而亂的 codebase,但 repo 到六、七百個時,索引與對應會變慢、變得難預測。
- 摘要與 knowledge graph替每個檔案、資料夾做摘要,要靠大量 LLM 處理,檔案一改就得重做;knowledge graph 前期投入很高,但遇到跨檔案的依賴關係很好用。
- 檢索與自我修正像給 agent 一張圖書館卡片,開發者要投入的少、結果也好,成本花在每次檢索上;Nupur 認為不是做產品的團隊多半適合這種;另一個選項是加 critic node 檢查有沒有偏離目標,偏了就重做,代價是多一道延遲。
- orchestration paradox模型越聰明越會一直想有沒有更好的方法,token 多半花在找方法而不是做事,Nupur 舉最新的 Opus 為例。
- 80-20 混合做法80% 讓高階模型自由研究,20% 的驗證與摘要用較死的 hard gate;失控時可設次數或逾時上限;那 20% 不需要高階推理模型。
- 一個 agent 包辦的問題因為 context window 夠大就全交給一個 agent,它會被輸入壓垮,四個任務可能只顧好兩個。
- 專家 agent 與 judge拆成各管一事的小 agent,再用 judge agent 合併;Nupur 用訂旅遊時飯店、地點、機票各自挑出對不上的結果當例子。
- Qodo 的 code review 架構context collector 收完 PR、context engine 與工具的資料後分給專長 agent,judge agent 再判斷這些結果和使用者相不相關。
- Q&A:agent 怎麼溝通有聽眾問 agent 之間怎麼溝通,Nupur 說底層用 LangChain,前一個 agent 的結果會整理成下一個的 prompt。
- Q&A:校準與 PR 歷史同一個框架在不同產業重點不同,所以把 PR 歷史索引起來,過去類似的問題會同時餵給專長 agent 與 judge agent。
- Q&A:架構與合規有聽眾問架構決策這類要取捨的事怎麼處理;Nupur 回頭講過去資深工程師、資安與稽核各管一塊,現在改由 architect 與合規人員寫準則,讓 agent 對照。
- Q&A:回饋加權錯誤或建議的分級、開發者是否接受建議,以及過去 PR 的結果,都會調整之後同類回饋的權重。
名詞
- Qodo
- Nupur 任職的公司,做 agentic code review
- context engine
- 替任務排出該看哪些內容的搜尋與排序機制,Nupur 比喻成 bouncer
- iterative retrieval
- 給 agent 一份主題索引,讓它自己判斷相關再去查,Nupur 稱為「圖書館卡片」
- orchestration paradox
- 越聰明的模型越會一直研究該用哪個方法,token 花在找方法而非執行
- 80-20 hybrid approach
- 80% 讓 agent 自由研究、20% 的驗證與摘要用較死的規則管住
- judge agent
- 收集各專家 agent 的結果,檢查彼此是否說得通、與使用者是否相關的 agent
- critic node
- 對照原始目標檢查結果,偏了就請 agent 重試的節點
- context collector
- Qodo 架構裡先從 PR、context engine 與工具收集 context 的一層