AI Engineer Europe 2026 · 演講 · 2026-07-08 · 10 分
別只下指令,要替 agent 加驗證
Your coding agent doesn't always follow your rules · Talha Sheikh,Checkout.com
Talha 發現自己一直在替 coding agent 把關,於是做了一層用 hook 觸發的確定性檢查,也主張價值已從寫程式轉到設計驗證。
概要
- 人變成了把關的那個人Talha 說不管給 Claude 完整 spec 還是幾乎沒有指示,每次都還有東西要自己開口修,agent 說做完了,還是得再檢查一遍。
- 用 hook 接一層確定性檢查Talha 做了 Vector,靠 Claude hook 在 session 結束時自動呼叫;測試寫在設定檔裡,沒過就一直告訴 Claude 重來,直到全過。
- 指示不等於驗證Talha 認為 spec、MCP server、sub-agent、完整 context 都該做,但給指示和給驗證是兩件事,指示再好還是得驗。
- 護欄多,模型可以小一點Talha 的推論是護欄夠多,Haiku 或開源模型也可能走到想要的結果;Opus 最貴,多花時間在 harness 上可以把成本壓下來。
- 要做成通用的模式每家公司都在做自己的強制檢查,各自要擋的東西不同,所以得是語言無關、人人能帶自己規則的 pattern,涵蓋對話、commit 前、多 agent、非同步到 LLM 當評審。
- 工作重心從程式碼移到驗證Talha 引用幾家公司的做法佐證,結論是「work on the harness and not on the code」。
原話
▶ 01:23“So the agent says it's done, but you have to check it anyway”
agent 說做完了,你還是得自己查一遍
▶ 02:40“it's not about whether Claude can actually do the task. It's about trust.”
重點不在 Claude 做不做得到,而在能不能信它
▶ 04:17“giving cloud instructions is not the same thing as giving it verification.”
給 Claude 指示,跟給它驗證不是同一回事
▶ 08:29“So it's not about can you code, but can you verify?”
重點不是你會不會寫,而是你能不能驗
▶ 08:29“So TLDR is work on the harness and not on the code.”
簡單說,把力氣花在 harness,不要花在程式碼
延伸
- Talha 把這層檢查的核心形容成一份契約:開發者自己定義「給定這個任務,要達成什麼」,中間怎麼驗由各自決定;只要能確定性地執行,任何語言、任何程式碼都能掛上。
章節
點時碼直接跳到原片的那一段。
- 做不完的修修補補請 Claude Code 做功能,sub-agent 跑完卻跑不起來,要一直叫它修,永遠還缺一小塊。
- 我就是那層把關不管給多少指示,每次都得自己告訴它該做什麼、怎麼檢查;agent 說完成,沒有別人能替 Talha 驗。
- 想要確定性的檢查Talha 想要 agent 宣告完成時,有一層確定性的機制去查事情是不是真的做完,而且照自己要的方式做。
- Vector 的做法靠 Claude hook 在 session 結束時呼叫 Vector;設定檔定義要檢查什麼,沒過就叫 Claude 重試,示範中第一次失敗、重試後全過。
- 問題是信任重點不是 Claude 做不做得到,而是能不能相信它把事情做完;Talha 說的 Claude 泛指所有 LLM agent。
- 被說不需要了Talha 到處介紹這個功能,後來一位 Anthropic 工程師說之後會有更聰明的 agent 或模型,不再需要這種東西。
- 新模型就夠了嗎Talha 提到 Project Glasswing 與 Mythos,但新模型能力提高,不等於自己要的那件事就解決了。
- 指示不是驗證最好的 spec、MCP server、sub-agent、context 都該有,但給指示不等於給驗證,還是得驗。
- 護欄與成本護欄夠多時,小模型或開源模型理論上也能交出要的結果;Opus 最貴,多投資 harness 可大幅降成本,也可改走 async。
- 每家都在做自己的Anthropic、Talha 的公司、Facebook 都在做各自的強制檢查,只合自己用的東西沒辦法分享,所以應該變成通用 pattern。
- 語言無關、各層都能跑檢查從對話、commit 前、多 agent、非同步 agent,到用 LLM 當評審都該能掛上,核心是一份「給定任務就要達成什麼」的契約。
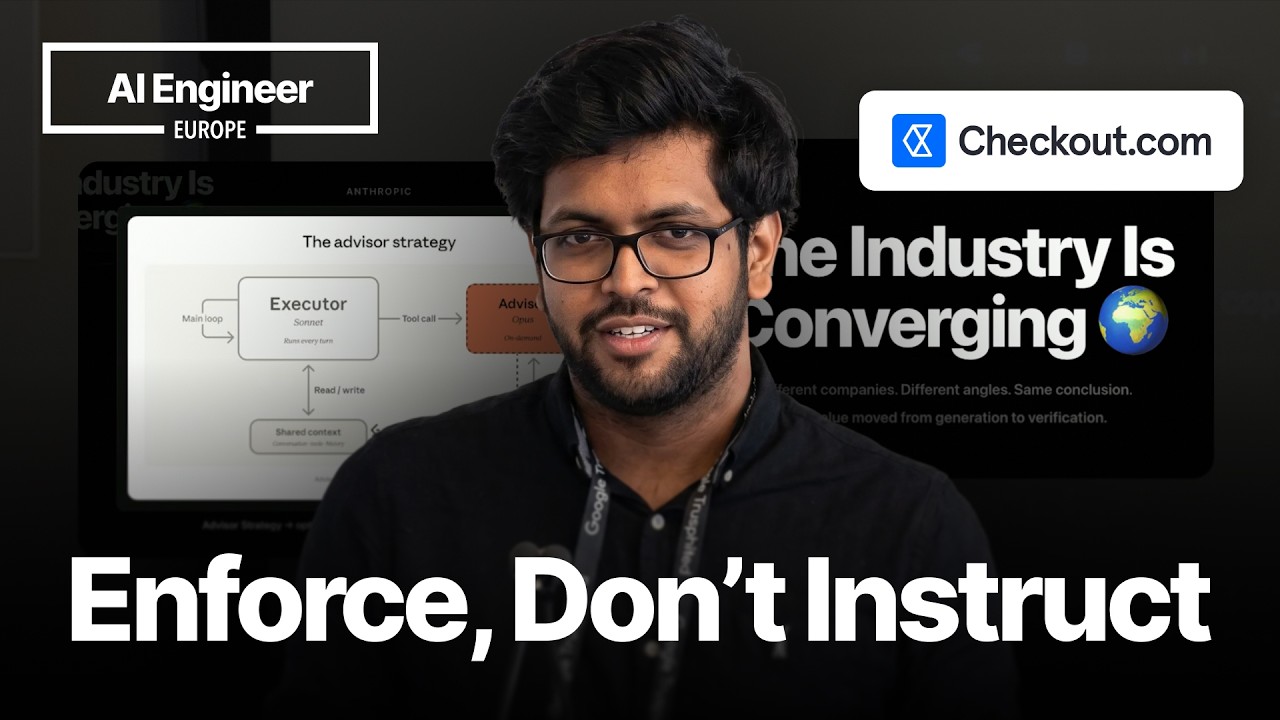
- 其他公司也在這樣做舉 Anthropic 的 advisor 模式、OpenAI 的 harness engineering、一家做完整 PR review 的公司、WorkOS 的「enforce, don't instruct」。
- 要慢下來慢的原因不是 agent 寫不快,而是驗證層;Talha 最愛的是 keynote 裡那句 slow the hell down。
- 價值移到驗證原先以為價值在寫出來的程式碼,現在在於設計出來的驗證;結論是顧 harness 而不是顧程式碼。
- 問答有聽眾問這東西是否公開,Talha 說是公開的,叫 Vector Harness。
名詞
- Vector
- Talha 自己做的產品,用 Claude hook 在 session 結束時自動執行設定檔裡的檢查,沒過就叫 Claude 重試;公開版叫 Vector Harness
- Claude hook
- 讓 Claude 在 session 結束等時機呼叫外部程式的機制,Vector 靠它觸發
- harness
- 包在 agent 外面的工具、context 與檢查;Talha 的結論是該把力氣放在這裡
- deterministic verification
- 用可重現的方式檢查 agent 的產出,相對於讓另一個模型去判斷
- LLM as a judge
- Talha 列在各層檢查之中、會非確定性地呼叫 LLM 的那一種
- Project Glasswing / Mythos
- Talha 說是 Anthropic 發表的專案,據說強到能解決一切,但不認為這代表不需要驗證
- advisor 模式
- Talha 轉述 Anthropic 最近推出的做法:一個 agent 負責寫程式,另一個 advisor 形成回饋迴路來驗證
- WorkOS
- Talha 引用當天 WorkOS 提出的「enforce, don't instruct」