AI Engineer Europe 2026 · 演講 · 2026-05-12 · 19 分
用強化學習把模型推上線
Lessons from Trillion Token Deployments at Fortune 500s · Alessandro Cappelli,Adaptive ML
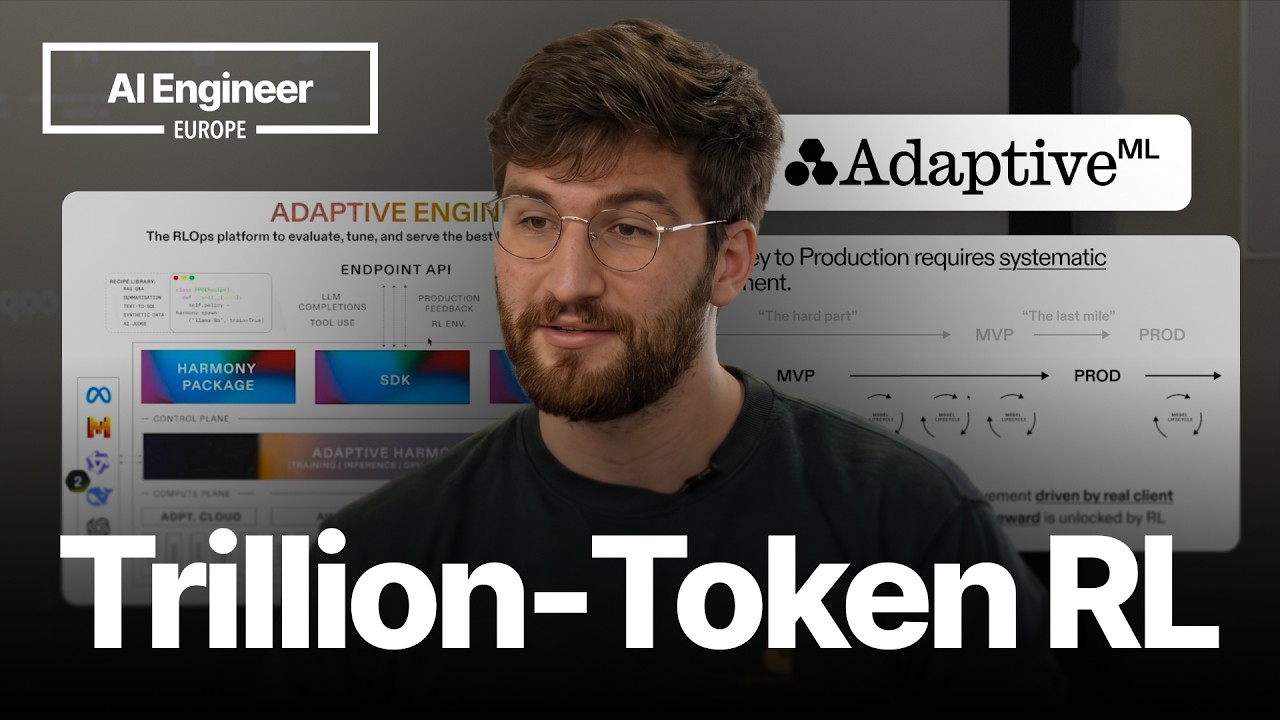
Alessandro 認為企業 AI 卡在 MVP 到 production 那一大段,而強化學習能讓小模型更便宜、更快,也能拿來訓練 agent 並吸收回饋。
概要
- 最後一哩路是迷思Alessandro 說大家以為難的是做出好看的 MVP,之後只剩最後一哩;真正的馬拉松其實是從 MVP 走到 production 之後,要靠各種回饋持續改進。
- 提示與微調改不動缺陷用專有模型,出問題只能改 system prompt;用 instruction fine-tuning,只能重做資料集,上線後可能每週都要重做。Alessandro 主張只有強化學習能系統性地吸收回饋。
- 小模型換來成本與速度同樣表現下,RL 訓出的模型比 SFT 小得多,服務成本較低。Alessandro 舉 AT&T 為例,光是摘要所有客服通話的逐字稿就要花上數百萬美元,也提到語音對語音系統需要約三分之一秒的延遲。
- Agent 更適合用 RL 訓練RL 本來就是為了在環境裡行動而設計。已有 agent 的客戶(如 Manulife)可以直接把模型接上現有環境;沒有的話可以模擬工具與使用者。獎勵可以是商業指標或 LLM judge。
- 沒資料也能起步agent 的訓練資料網路上抓不到,但有環境與獎勵,就等於多了一條合成資料管線,能做 rejection sampling 來啟動第一輪訓練。
- 人的角色在定義獎勵Alessandro 說大規模標註要不貴、要不沒用。人主要負責寫 rubric 與 LLM judge 的 prompt,花幾分鐘到幾小時,不必一做就是幾週。RL 的代價是難,所以 Adaptive 提供預建 recipe。
原話
▶ 00:39“how reinforcement learning, RL, is not just any other algorithm for post-training, but is an algorithm that at its core will bring models to production.”
RL 不只是另一種後訓練演算法,它的核心是把模型帶進 production
▶ 03:04“Getting to an MVP is not easy, but it's just the first mile.”
做出 MVP 不容易,但那只是第一哩
▶ 06:05“half of a second is already weird when you're talking to someone”
跟人講話時,等半秒就已經怪怪的
▶ 14:42“The only catch with AREL is that reinforcement learning is actually hard”
RL 唯一的代價,就是它真的很難
延伸
- Alessandro 提到同事 Letizia 與 João 錄了一場 workshop,示範如何接上現有環境訓練模型,這場沒有展開細節。
- Alessandro 說 CCS 是醫療用品公司,客服裡有慌張來電者的情境,理想做法是轉接真人或代為通報,這場只點到為止。
- 語音客服要壓到三分之一秒,Alessandro 建議用 10B 左右的小模型,例如最新的 Gemma 或 Mistral。
章節
點時碼直接跳到原片的那一段。
- 自我介紹Alessandro 是 Adaptive ML 共同創辦人,公司做 RL Ops 平台,客戶有 AT&T、Manulife、CCS。
- 從 Falcon 到 RLAlessandro 三年前參與訓練 Falcon,認為開源模型要走到 production、補上和專有模型之間的差距,缺的就是強化學習。
- 最後一哩路的迷思多數 MVP 建在專有模型或 instruction fine-tuning 上,兩者都無法有系統地修補缺陷。
- 真正的馬拉松從 MVP 到 production 才是長路,要靠持續再訓練吸收客戶回饋、商業指標與環境獎勵。
- RL 對比 SFT 與 prompting三者都在引導模型行為,但 Alessandro 說 RL 的效果遠高於另外兩者,同樣表現可以用小得多的模型達成。
- 小模型的成本帳模型小、服務便宜,tokenomics 才算得過來;AT&T 的通話摘要是例子。
- 延遲是硬限制語音客服半秒就顯得怪,理想是三分之一秒,這只有小模型做得到;自己擁有模型也不怕上游更新改變表現。
- Agent 讓問題更難Agent 要更多 token、容錯更低,還能改動資料庫;Alessandro 說 RL 的優勢在 agent 上只會更大。
- 環境與獎勵已有 agent 流程就直接接上去訓練;沒有就模擬工具與使用者。獎勵可以是商業成果、KPI 或 LLM judge。
- 沒資料怎麼辦環境加獎勵本身就是合成資料管線,可做 rejection sampling;既有的客服對話可以拿來訓練模擬使用者。
- 人在迴路的位置Alessandro 批評昂貴的標註活動不是太貴就是沒用,人的價值在對齊獎勵的定義。
- 獎勵訊號的來源程式能否執行、KPI;CCS 要最大化的是 containment rate;語氣等開放問題交給 LLM judge。
- Adaptive Engine平台把觀察、評估、訓練與服務放在一起,底下用最新的開源模型。
- RL 的代價RL 很難,PPO 就得同時調度四個大型語言模型,所以平台提供預建 recipe。
- Q&A:怎麼用人類回饋回饋少時拿來改 LLM judge,上線後有上千筆回饋就訓練 reward model;隱性回饋視情況而定。
名詞
- Adaptive ML
- Alessandro 共同創辦的公司,做 RL Ops 平台,讓大型企業訓練、評估並部署自己的專用模型
- Adaptive Engine
- 公司的 RL Ops 平台,把觀察、訓練與服務放在一起,並提供預建的訓練 recipe
- RL Ops
- Alessandro 對強化學習維運平台的說法,涵蓋評估、調校與上線服務
- Falcon
- Alessandro 約三年前參與訓練、說是當時採用度最高之一的開源模型
- tokenomics
- Alessandro 用來指一個用例的 token 成本是否划算;模型小,成本才算得過來
- LLM as a judge
- 用語言模型當獎勵來源,評斷語氣、是否符合商業規範等開放性問題,人只負責定義 rubric
- rejection sampling
- Alessandro 說的做法:用獎勵篩出好的軌跡,組成資料集來啟動第一輪訓練
- containment rate
- 客戶 CCS 客服系統要最大化的指標,即由模型從頭到尾處理完的通話比例
- PPO
- Alessandro 提到的知名 RL 演算法,需要同時調度四個大型語言模型
- GSPO
- Alessandro 提到的最新 RL 演算法之一,平台已有預建 recipe