AI Engineer Europe 2026 · 演講 · 2026-07-08 · 19 分
教 coding agent 做試算表
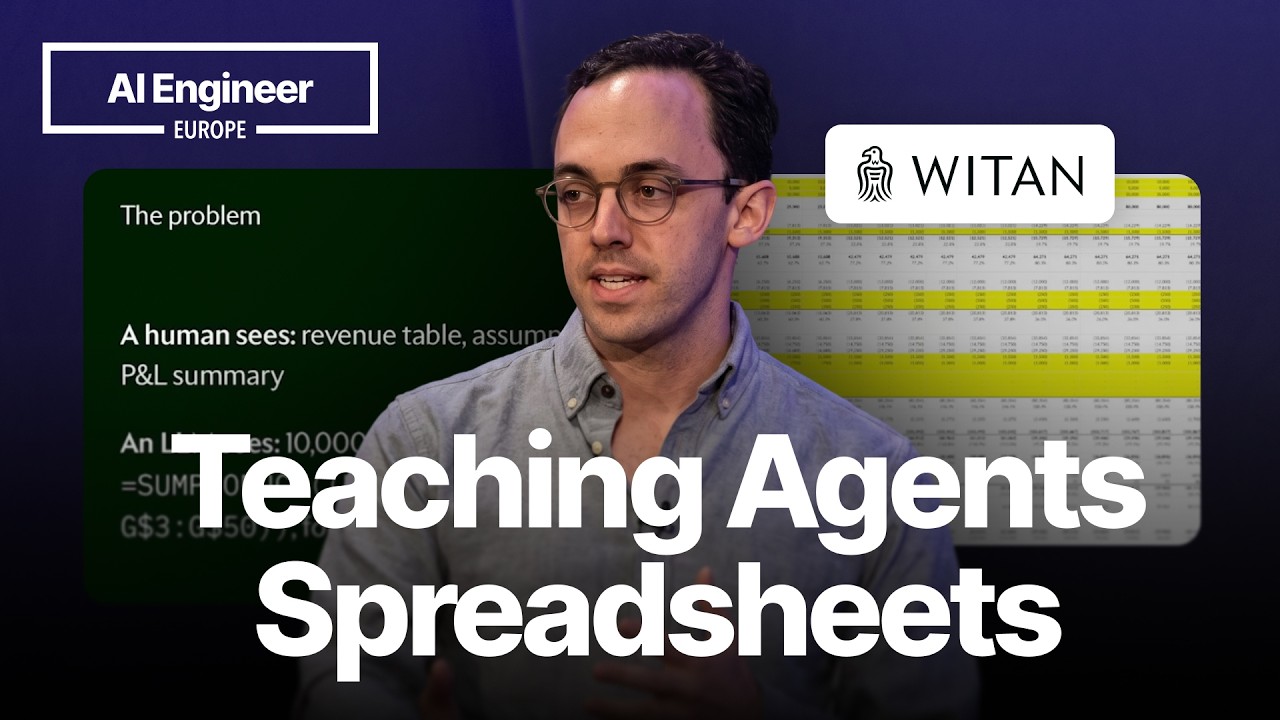
Teaching Coding Agents to do Spreadsheets · Nuno Campos,Witan Labs
Nuno 花四個月讓 coding agent 學會操作試算表,財務分析基準從約 50% 做到 92%。這場講哪些做法是死路、REPL 與驗證迴圈為什麼有效,以及評估怎麼做才可靠。
概要
- 試算表對 LLM 其實很難人打開 Excel 一眼就看得出結構,LLM 看不到。問它 revenue 是多少,它得先判斷是哪種 revenue、哪一季、哪一年,找到的數字是輸入值還是公式。
- 一個 Node.js REPL 取代十幾個工具原本累積約 15 個工具,後來全部變成同一個 REPL 裡的 JavaScript 函式,agent 可以在一次呼叫裡組合使用。Nuno 說這是最大的突破。
- REPL 比 code mode 多了持久狀態變數在呼叫之間會留著,agent 寫的腳本變短,每一步之間可以穿插推理。新增能力也只要多開幾個方法、更新 TypeScript 型別定義檔。
- 驗證迴圈比介面更耐久他們做了公式計算引擎與渲染引擎,讓 agent 自己檢查結果。Nuno 強調引擎必須高擬真,只實作一半 Excel 公式反而更糟。
- 評估盡量用確定性比對一開始只靠 LLM as a judge,分數變動時分不出是 agent 變了還是評審變了。後來改用黃金試算表,能比對的地方就不交給 LLM 評分。
- 看 trace,別當成模型失誤基礎設施的 bug 常常看起來像推理失敗,例如 prompt 裡的範例寫錯、工具壞掉後模型一直重試。
原話
▶ 06:28“it's basically code mode with persistent state.”
它基本上就是有持久狀態的 code mode
▶ 11:15“So that verification loop is really only as good as the engines that power it.”
驗證迴圈的品質,就看背後的引擎有多好
▶ 15:12“And infrastructure bugs when you're building agents many times end up looking like reasoning failures”
做 agent 時,基礎設施的 bug 常常看起來像推理失敗
▶ 16:17“Then you've kind of invented a bad scripting language.”
agent 若連續、甚至平行做很多次工具呼叫,那你等於發明了一個很爛的腳本語言
延伸
- Nuno 說這四個月裡有四五次模型改版,每次模型越強,越能從驗證迴圈得到更多。
- 領域知識的作用,Nuno 說與其是教模型,不如是提醒它把注意力放在這個任務該關注的事上。
章節
點時碼直接跳到原片的那一段。
- 目標與成績四個月讓 coding agent 把試算表做得像寫 Python、JavaScript 一樣好,財務分析基準從約 50% 做到 92%。
- 試算表為什麼難人一眼看得出表格、假設與圖表的結構,LLM 看不到,連 revenue 指的是哪一個都要先猜。
- 三個 agent 的架構早期把工作拆給三個 agent,核心的編輯 agent 走五步流程,錯誤改成出在規劃階段,但 discovery 只跑一次、context 不流通,最後太僵硬。
- 試遍各種表示法SQL、XML 都沒辦法單獨撐起來;CSV 或 TSV 視圖留下來成為常用的一塊,HTML 帶出版面與格式,促成渲染引擎。
- 換成單一 REPL約 15 個工具改成一個 Node.js REPL 裡的函式;底層處理檔案的程式用 C#,REPL 只負責讓 agent 操作。
- 換之前與換之後以前探索一份試算表要 10 到 15 次工具呼叫,常常逾時;換之後一次呼叫組合所有動作,結果同時回來。
- REPL 與 code modecode mode 把多個工具併成一次呼叫,REPL 再加上持久狀態,腳本變短、能穿插推理,新增能力也更簡單。
- 從 50% 到 92%其他改進(模糊搜尋、公式追蹤、system prompt、修 bug)都不如 REPL 劇烈;五分鐘限制內幾乎沒有逾時。
- 驗證迴圈像寫程式要靠編譯器與測試,試算表要靠公式引擎與渲染引擎;引擎不夠完整,結果比沒有還糟。
- 介面會變,驗證不會REPL 是現階段最好的介面,因為模型最擅長寫程式;之後若 computer use 追上,介面可能換掉,但驗證迴圈會留下來。
- 加入領域知識領域知識寫進 prompt,歷經各種工具改版都還有效,作用是讓模型把注意力放在對的地方。
- 評估的歷程從只用 LLM as a judge,改成能用的地方就用黃金試算表做確定性比對,因為這樣分數變動的原因才說得清楚。
- 基礎設施 bug工具壞掉或範例寫錯,會被誤看成模型推理失敗,所以要實際去看 trace。
- 可推廣的幾點用真的腳本語言取代連續呼叫、建立回饋迴圈、重視介面、規劃、領域知識,以及盡量確定性評估並檢查 trace。
名詞
- Witan Labs
- Nuno 所屬的公司,這場講他們讓 coding agent 處理試算表的經驗
- REPL
- 這場的核心介面,agent 用一個 Node.js REPL 呼叫原本的十幾個工具,變數會跨呼叫保留
- code mode
- 把多個工具組合進單一次工具呼叫的做法,Nuno 說 Anthropic API 與 Cloudflare 都談過
- formula engine
- 計算試算表公式的引擎,讓 agent 驗證自己寫的公式
- render engine
- 把一個範圍的內容連同格式與版面畫成圖片的引擎,供 agent 看渲染結果
- LLM as a judge
- 用 LLM 當評審打分數的評估方式,這場先用它,後來盡量換成確定性比對
- golden spreadsheet
- 帶有一組輸入與輸出的標準試算表,把模型做的試算表當黑箱,輸入相同數字比對輸出