AI Engineer Europe 2026 · 演講 · 2026-04-27 · 19 分
Gemma 4 架構與多模態拆解
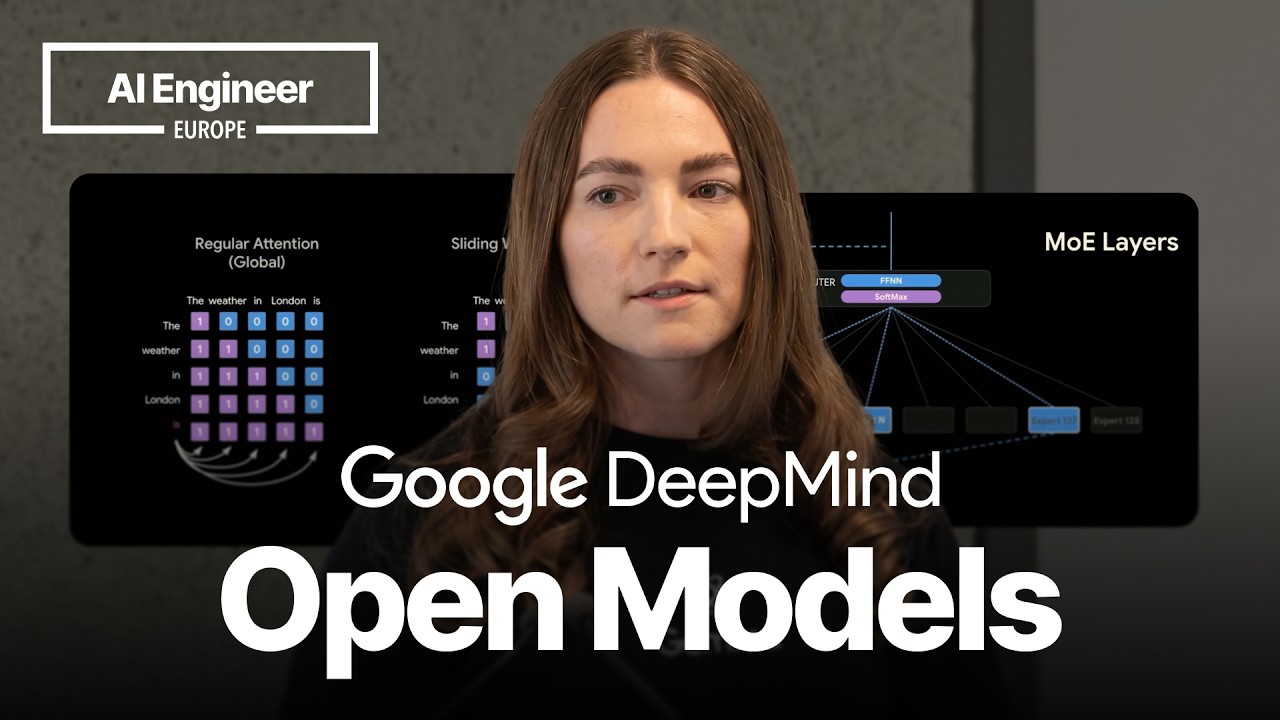
Gemma 4 Deep Dive · Cassidy Hardin,Researcher
Google DeepMind 的 Cassidy Hardin 介紹 Gemma 4 的四種尺寸,並逐項拆解注意力、MoE、per-layer embeddings、視覺與音訊編碼器的設計,最後說明怎麼取得模型。
概要
- 四種尺寸,兩條路線Gemma 4 有兩個給裝置端用的 effective 模型,加上 26B MoE 與 31B Dense 兩個較大的模型。Cassidy 說 26B MoE 是 Gemma 家族第一個 MoE。
- 授權改成 Apache 2.0Cassidy 說這是刻意的決定,目的是讓一般開發者更容易把 Gemma 放進從測試到部署的整個開發流程。
- 注意力層的改法local 與 global 層交錯,大模型是 5 比 1,effective 2B 是 4 比 1,最後一層一定是 global。global 層改用 grouped query attention,八個 query 共用一組 key 與 value。
- MoE 與 per-layer embeddingsMoE 有一個每次都啟動的 shared expert,加 128 個 expert、每次選 8 個。effective 模型靠 PLE 把額外的 embedding 表放在 flash memory,不佔 VRAM。
- 視覺可以調解析度圖片支援可變長寬比與可變解析度,開發者能自己決定一張圖要花多少 soft token。取代了 Gemma 3 的 pan and scan。
- 音訊只在小模型E2B 與 E4B 多了音訊輸入,用 audio tokenizer 加 305 million 參數的 conformer,目標是翻譯與語音辨識。
原話
▶ 02:01“This was deliberately done in order to make our models more accessible for the everyday developer.”
這是刻意為之,讓一般開發者更容易使用我們的模型,指的是改用 Apache 2.0 授權
▶ 09:13“The big advancement that comes here is the fact that we store our PLE, our per-layer embedding table, in flash memory as opposed to VRAM.”
這裡最大的進展,是我們把 PLE,也就是 per-layer embedding 表,存在 flash memory,而不是 VRAM
▶ 09:35“VRAM is one of the largest constraints on on-device.”
VRAM 是裝置端最大的限制之一
▶ 18:04“You have the option to download and self-host all of our models.”
我們所有的模型,你都可以下載並自行架設
延伸
- 26B 每次需要的參數量,Cassidy 開頭說 3.9 billion,後面說 3.8 billion,沒有說明差在哪。
- 31B 與 26B 的 sliding window 大小這場沒有講清楚,只明確說小模型是 512 個 token。
- 結尾 Cassidy 說可以回答 Gemma 的問題,這場沒有問答內容。
章節
點時碼直接跳到原片的那一段。
- 開場與四種尺寸Cassidy 自我介紹後說明 Gemma 4 有四種尺寸:兩個裝置端的 effective 模型,加上 26B MoE 與 31B Dense。
- 排名與 Apache 2.031B 與 26B 在 LM arena 的開源模型中都排進前六,同時授權改為 Apache 2.0,Cassidy 說是為了讓一般開發者更容易使用。
- 31B Dense31B 定位成為進階推理打造的多模態模型,256K 的 context length,原生支援 thinking、function calling 與結構化 JSON 輸出。
- 26B MoE26B 是 Gemma 第一個 MoE,總共 128 個 expert,推論時只用 8 個,在效率與接近 31B 的表現之間取捨。
- 兩個 effective 模型E2B 與 E4B 專為裝置端設計,輸入有文字、圖像與音訊,輸出只有文字。Cassidy 說各項基準都明顯勝過 Gemma 3 家族。
- local 與 global 注意力交錯比例是 5 比 1(effective 2B 為 4 比 1),local 層用 sliding window,最後一層固定是 global;小模型的 window 是 512 個 token。
- Grouped query attentionglobal 層仍要看所有前面的 token,記憶體負擔大;local 層兩個 query 共用一組 key 與 value,global 層是八個,key 與 value 的長度從 256 加倍成 512。
- MoE 的結構用 MoE 取代標準 feed-forward 層:一個每次都啟動的 shared expert(大小是一般 expert 的三倍),加 128 個 expert、每次由 router 選 8 個。
- 「effective」是什麼意思指運作時需要的參數量,與全部表徵參數量的差別;E2B 是 2.3 billion 的 effective 參數,表徵深度為 5.1 billion。
- Per-layer embeddings每個 token 在每一層都有自己的 256 維 embedding,這張表存在 flash memory 而非 VRAM,E2B 有 35 層、更大的有 42 層。
- 視覺編碼器31B 與 26B 用 550 million 參數的視覺編碼器,effective 模型用 150 million 的;支援可變長寬比,並提供五種解析度。
- 可變解析度與 token 預算開發者可選一張圖分配多少 token:OCR、物件辨識要高預算,純文字應用可以壓低;Gemma 3 的 pan and scan 要把圖切成多張依序處理。
- Patch 到 soft token3 乘 3 的 patch 合成一個 embedding,token 預算 280 對應 2,520 個 patch;OCR 與物件偵測可用 560 與 1120。
- 音訊編碼原始音訊經 MEL spectrogram 與兩層卷積降採樣,再交給 305 million 參數的 conformer,目標是翻譯與語音辨識。
- 總結與取得方式小模型支援文字、視覺、音訊,大模型著重推理、agentic workflow 與 coding;四個都能從 Hugging Face、Kaggle、Ollama 下載,31B 與 26B 也能在 AI Studio、Vertex 直接用。
名詞
- Gemma 4
- Google DeepMind 的開源模型家族,有 E2B、E4B、26B MoE、31B Dense 四種尺寸
- Effective 2B / 4B(E2B、E4B)
- 給手機、平板、筆電用的小模型,運作所需參數比全部表徵參數少,輸入含文字、視覺、音訊
- MoE
- 混合專家架構,26B 版有 128 個 expert,推論時選 8 個,另有每次都啟動的 shared expert
- Local / global 層
- local 層只看前面固定長度的 token(sliding window),global 層看所有前面的 token
- Grouped query attention
- 多個 query 共用一組 key 與 value;local 層兩個一組,global 層八個一組
- PLE(per-layer embeddings)
- 每一層各有一張 256 維的 embedding 表,存放在 flash memory 以省下 VRAM
- Soft token budget
- 開發者替每張圖指定要花多少 token 的設定,共有五種解析度可選
- Pan and scan
- Gemma 3 處理不同尺寸圖片的方法,把圖切成多個方塊,當成數張圖依序處理
- Conformer
- E2B 與 E4B 的音訊編碼器,305 million 參數,輸入 audio tokenizer 產出的 embedding
- LM arena
- Cassidy 用來說明 31B 與 26B 在開源模型中名列前六的排行榜