AI Engineer Europe 2026 · 演講 · 2026-05-16 · 20 分
用 Playwright 測行為,不只衝覆蓋率
Beyond Code Coverage: Functionality Testing with Playwright MCP · Marlene Mhangami,Microsoft
Marlene 先用 GitHub 的 commit 數字和一份研究說明,AI 寫得越多越需要乾淨的程式碼;再示範讓 coding agent 用 Playwright 先寫行為測試、再寫程式。
概要
- 程式碼暴增,產能不一定跟著增Marlene 引用 GitHub 的數字,2025 年約有 10 億個 commit,2026 年每週約 2.75 億個,接著問的是,這些程式碼有沒有換來更高的產能。
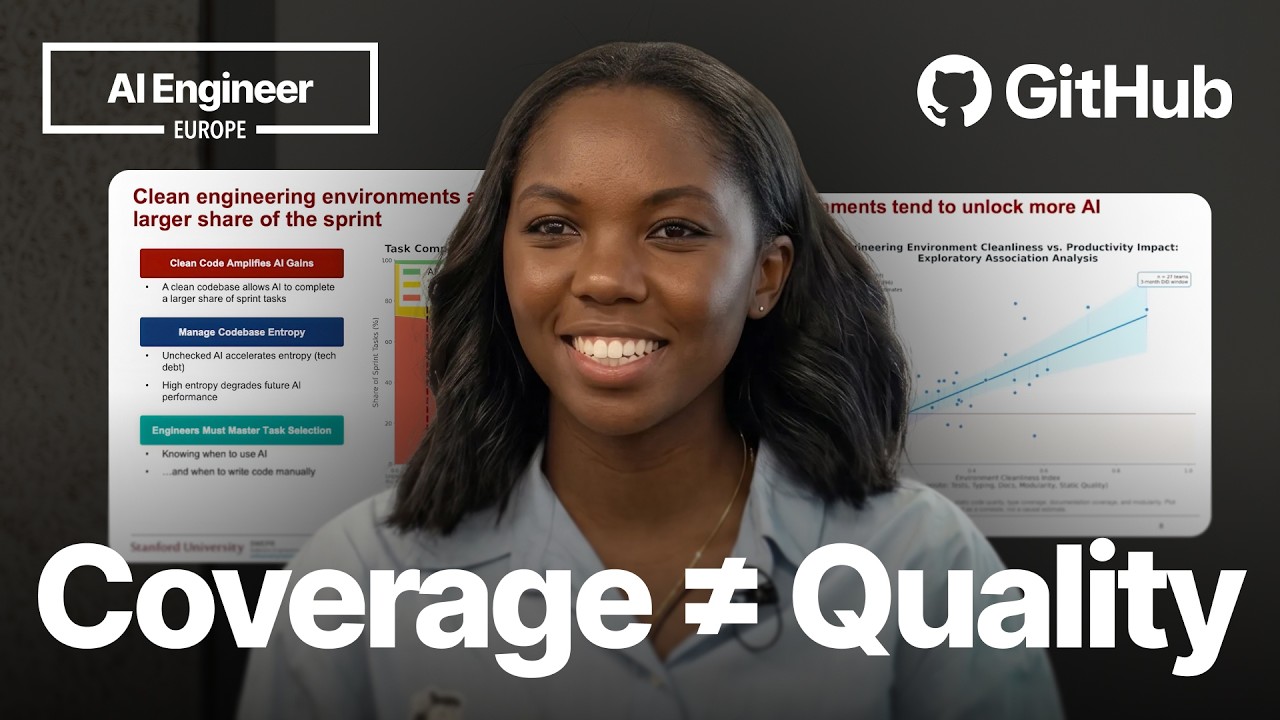
- 乾淨的程式碼庫才放得大 AI 的好處Marlene 轉述一份 Stanford 研究,說乾淨的程式碼庫會放大 AI 帶來的增益,沒有把關的 AI 則會放大混亂。建議把測試覆蓋、型別覆蓋、文件和模組化當作重點。
- 單元測試和覆蓋率有盲點測試綁在實作細節上,改個名字就會壞;AI 又常寫出自我肯定的測試,覆蓋率全綠,系統行為卻沒被驗證。
- 改測行為,用 Playwright 驅動瀏覽器Playwright 模擬使用者操作,做端對端測試。Marlene 的做法是讓 agent 針對功能需求先寫會失敗的 Playwright 測試,再寫程式讓它通過。
- AI 讓紅、綠兩步變快,時間留給重構Marlene 認為 TDD 以前被嫌慢,有了 AI 之後前兩步很快,開發者該把最多時間花在檢視並改善 agent 寫出的程式碼。
- 現場示範與使用建議Marlene 用 GitHub Copilot CLI 加 Playwright MCP server 走完一輪,最後給了幾點實務建議,Q&A 也回答了狀態管理、行動版和非瀏覽器的問題。
原話
▶ 02:48“clean code bases amplify AI gains and AI productivity, while unchecked AI in a code base is going to amplify entropy.”
乾淨的程式碼庫放大 AI 的增益,沒把關的 AI 則放大混亂;這是 Marlene 轉述那份 Stanford 研究的結論
▶ 07:52“AI sometimes generates self-affirming tests.”
AI 有時會生出自我肯定的測試
▶ 09:26“that red part and the green part are fast.”
紅燈和綠燈那兩段變快了
▶ 16:35“commit your code before you actually get it to fix the test.”
在讓它修測試之前,先把程式碼 commit
延伸
- Marlene 用一段 Playwright 腳本說明測試長什麼樣子:先到玩具頁、找到搜尋框、填入 Furby,瀏覽器就會自動跑完搜尋。
- Marlene 說讓 agent 修測試前先 commit,是因為不 commit 的話,agent 可能記不得之前改過什麼。
章節
點時碼直接跳到原片的那一段。
- 開場自我介紹Marlene 是 Microsoft 與 GitHub 的資深 developer advocate,所在的 Core AI 團隊研究開發者怎麼在產品裡用 AI。
- GitHub 的 commit 數字Marlene 引用 Octoverse 報告,2025 年約有 10 億個 commit,並說 GitHub 的 COO 前幾天提到每週約 2.75 億個,照這個速度年底約 140 億個。
- AI 共同署名的 commitMarlene 說有愈來愈多 commit 由 AI agent 共同撰寫,Claude 與 Copilot 會署名,Codex 不會,但可以從程式碼用詞看出來。
- AI 真的提高產能嗎Marlene 拿 AI Engineer 去年一場演講引用的 Stanford 研究(12 萬名開發者)回答:乾淨的程式碼庫放大 AI 增益,未把關的 AI 放大混亂,案例中 PR 變多但品質下降、返工變多,整體有效產出只多約 1%。
- 要把做法標準化Marlene 主張業界要統一一些保持程式碼乾淨的做法,並承認有人在這場大會上主張閉著眼睛直接出貨。
- 紅綠 TDD介紹 Simon Willison 近期寫的紅綠 TDD:先寫失敗的測試,再只求通過,最後專心重構。
- 對 TDD 的批評TDD 在 2014 年被宣告已死,DHH 當時的文章批評過度偏重單元測試;測試若綁在方法名稱上,改名就壞,改測行為或穩定的 API 契約才撐得過重構。
- AI 寫的自我肯定測試提到 Ian Cooper 的 TDD 講座,並指出 AI 生成的測試常讓覆蓋率全綠,卻沒驗證系統行為。
- Playwright 簡介Playwright 是 Microsoft 做的開源框架,在瀏覽器模擬使用者操作,可用有畫面或無頭模式跑。
- AI 加速 TDD有 AI 之後紅、綠兩步很快,最多的時間該花在重構階段,檢視 agent 寫的程式。
- 接上 agent 的三種方式可用 Playwright MCP server、CLI,或 Playwright Agents,後者會裝入 planner、generator、healer 三個 agent.md 檔。
- Demo 情境與需求情境是玩具公司 Tailspin Toys 要加搜尋列與類別、價格篩選,Marlene 在 Copilot CLI 用 WorkIQ 把 M365 裡的需求信帶進終端機。
- 先寫失敗的測試Marlene 要求 Copilot 用紅綠 TDD,每個功能先寫會失敗的 Playwright 測試;觸發測試的是功能需求,不是新增一個方法。
- 測試跑過的畫面Marlene 切到先前做好的版本,agent 自己開頁面、輸入、點篩選,搜尋與篩選全部通過;之後才進重構。
- 實務建議把測試截圖附在 PR、用無頭模式跑、讓 agent 修測試前先 commit、一個功能一個測試。
- Q&A有聽眾問狀態管理,Marlene 建議用 Playwright Agents,或直接測 API;也確認可測行動版與桌面版,目前只支援瀏覽器。
名詞
- Playwright
- Microsoft 做的開源端對端測試框架,在瀏覽器模擬使用者操作
- Playwright MCP
- 讓 coding agent 操作 Playwright 的 MCP server,demo 裡裝在 GitHub Copilot CLI
- Playwright Agents
- 會裝入 planner、generator、healer 三個 agent.md 檔:規劃測試、產生測試、修復測試
- red-green TDD
- 先寫失敗的測試,再寫程式讓它通過,最後重構
- GitHub Copilot CLI
- Marlene demo 用的終端機 coding agent
- WorkIQ
- Microsoft 做的 skill,讓開發者把 M365 的資料帶進終端機
- Simon Willison
- 近期寫了介紹紅綠 TDD 的部落格文章
- DHH
- Rails 作者,2014 年發文批評過度偏重單元測試
- Ian Cooper
- Marlene 推薦的講座「TDD where it all went wrong」的講者
- Tailspin Toys
- Demo 虛構的玩具公司情境