AI Engineer Europe 2026 · 演講 · 2026-05-22 · 18 分
模型變快,開發者要慢下來
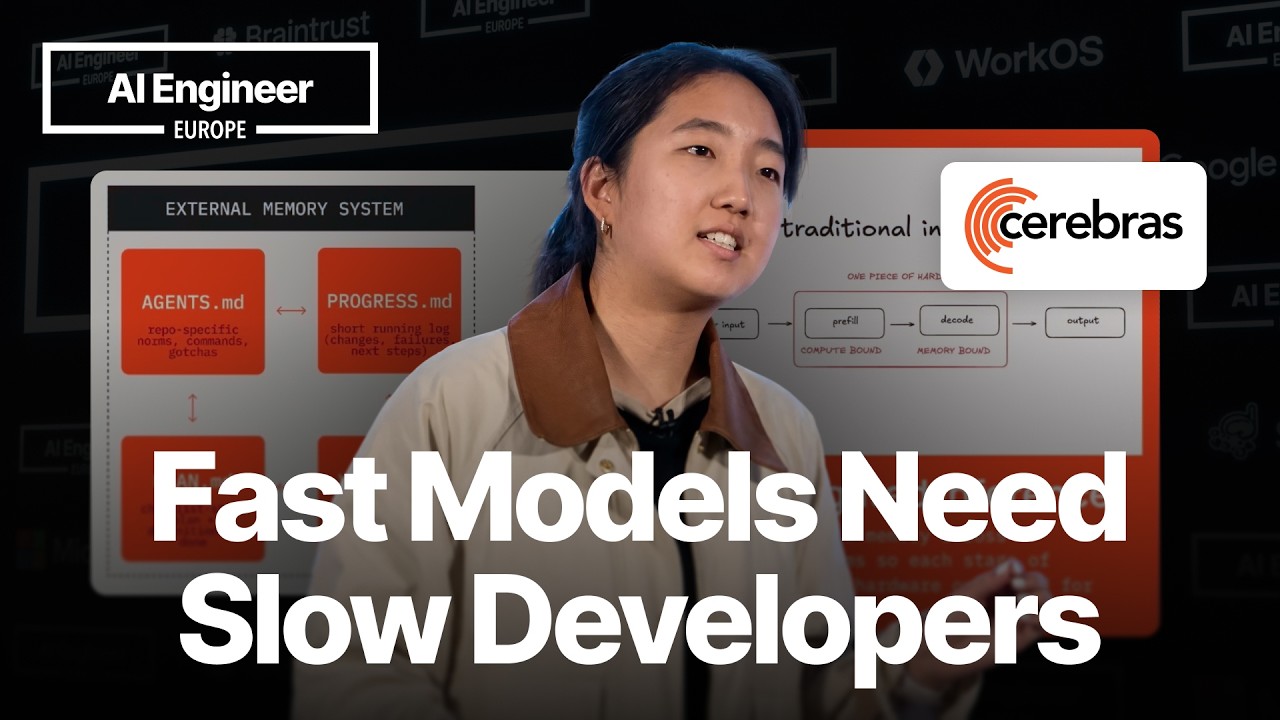
Fast Models Need Slow Developers · Sarah Chieng,Cerebras
Sarah 認為每秒 1,200 tokens 的 Codex Spark 會放大舊習慣的問題,整場講怎麼改選模型、驗證、協作與 context 的做法。
概要
- 速度放大壞習慣Sarah 說大家因為生成太慢,養成寫巨型 prompt、堆大 commit、同時開多個 agent 的習慣,模型變快後這些習慣只會更快產出爛程式碼。
- 推論堆疊同步變快Sarah 從硬體、模型架構到推論服務逐層說明,點出記憶體搬移占推論延遲的 50% 到 80%,以及 prefill 與 decode 分開跑的趨勢。
- 大模型規劃,快模型執行Sarah 建議用 GPT-5.4 做規劃,再派 Codex Spark 子 agent 逐步執行,也可把成功的流程存成 skill 讓快模型重複做。
- 快到可以隨時驗證測試、lint、diff review、重構都能加進每一步,也能一次產出 15 版或 75 版再挑最好的。
- 人要坐在駕駛座Sarah 主張兩三個 session 即時協作,由人做決策,並用 agents、plan、progress、verify 四個 MD 檔外部化記憶。
原話
▶ 01:29“unless we fix them, they're going to start generating 1,200 tokens per second of bad code.”
如果不改掉這些習慣,它們就會變成每秒 1,200 tokens 的爛程式碼
▶ 07:55“we're now going to be generating technical debt at a level that we've never seen before”
我們產生技術債的規模會是前所未見
▶ 11:19“it almost allows us to artificially induce taste into our model output”
這幾乎能讓我們人為地替模型輸出灌入品味
▶ 12:45“The AI should always be helping you make decisions, not the other way around.”
該是 AI 幫你做決定,而不是反過來
▶ 14:55“you can't get away with sloppy practices anymore”
再也不能用草率的做法矇混過去
延伸
- Sarah 用兩件事說明 disaggregated inference 已經商用化:NVIDIA 幾個月前以 20 billion 美元買下 Groq,以及 Cerebras 與 AWS 合作,把 Cerebras 的晶圓和 AWS 自家的晶片搭在一起服務。
- 做推論最佳化的公司,Sarah 點名 Together、Base10、Modal、Fireworks,沒有逐一介紹。
- 一次產出多版再挑的做法,Sarah 說特別適合重視數量或多樣性的工作,例如找研究方向或平面設計。
章節
點時碼直接跳到原片的那一段。
- 慢速養出的壞習慣Sarah 點名寫超長 prompt 想一次到位、堆大量 commit、同時開 10 個 agent 等著跑,這些都是 AI 生成太慢養成的習慣。
- Codex Spark 的速度Sarah 說 Cerebras 與 OpenAI 約一個月前推出 Codex Spark,每秒 1,200 tokens,Sonnet 與 Opus 家族約每秒 40 到 60,差了 20 倍。
- 壞習慣會跟著加速如果習慣不改,原本每秒 50 tokens 的爛程式碼,會變成每秒 1,200 tokens 的爛程式碼,這是整場的主題。
- 模型速度兩年沒變模型越來越大、越來越聰明,但各大家族的速度兩年來都在每秒 50 到 150 tokens,Codex Spark 只是第一個。
- 推論堆疊為何變快Sarah 說整條推論堆疊同時被優化,先從硬體講起:記憶體搬移占了推論延遲的 50% 到 80%,GPU 的資料放在晶片外的 HBM,Cerebras 把記憶體放在晶片上的 SRAM。
- 拆開 prefill 與 decodeSarah 說 disaggregated inference 這幾個月已商用化:prefill 吃算力、decode 吃記憶體,分別交給不同硬體。
- 模型架構與推論優化往上一層是為硬體量身調整的模型架構,例子是 MoE 與修剪沒被啟動專家的 REAP;最上層是推論服務商,重點之一是 KV cache 重用。
- 同時開一堆 agent 的風險社群上有人同時跑六個 Claude Code 終端機、500 多個 agent 的集群,Sarah 認為這些設定產出大量沒人驗證的程式碼,推論變快只會讓技術債更快堆起來。
- 大模型規劃,小快模型執行開發者以前只看智慧與成本,現在多了速度這個維度;Sarah 建議用 GPT-5.4 這類大模型做規劃,再派 Codex Spark 子 agent 逐步執行,也可把成功的流程做成 skill 讓快模型反覆跑。
- 驗證可以隨時做Sarah 說在每秒 1,200 tokens 下,測試、lint、pre-commit hooks、diff review、瀏覽器 QA 都幾乎是即時的,可以加進每一步,不必等到推送前才做。
- 一次產出多版再挑要做一個導覽列,可以讓模型一次產 15 版,再派五個子 agent 各產 15 版共 75 版,從中挑最好的,Sarah 說這等於替模型輸出人工灌入品味。
- 當結對的程式設計師Sarah 主張別再開一個 session 就去等,而是兩三個 session 坐在旁邊即時協作,可以禁止刪檔、限制 diff 大小、只准讀寫,並隨時下指令修正,決策要由人來做。
- 自動重構幾乎免費重構跟驗證一樣可以寫進流程,每完成一項任務就讓模型刪掉沒用到的 import、清掉多餘程式碼、統一函式結構。
- Context 管理更重要以前 10 分鐘才會碰到 compaction,現在除以 20 只要 30 秒;Sarah 建議把大任務拆成有邊界的小目標,並避開 context 80% 到 100% 的區間。
- 四個檔案的外部記憶Sarah 介紹用 agents、plan、progress、verify 四個 MD 檔,讓每個新 session 讀 progress 就知道做到哪,由 verify 檢查每一步,再由 Codex Spark 逐項執行清單。
- 結論:開發體驗會更好Sarah 列了幾個 Codex 常用指令,並總結重點不只是模型變快,而是開發者體驗會好很多,也能用不痛苦的方式避免爛程式碼。
名詞
- Codex Spark
- Cerebras 與 OpenAI 約一個月前推出的程式碼模型,Sarah 說每秒可生成 1,200 tokens
- Cerebras
- Sarah 任職的公司,職稱是 head of developer experience;這家公司做的是自稱最大最快的 AI 處理器
- Memory wall
- 硬體上的記憶體瓶頸,權重與 KV cache 在記憶體與晶片間搬移,占推論延遲的 50% 到 80%
- Disaggregated inference
- 把 prefill 與 decode 拆到不同硬體執行的做法,Sarah 說近幾個月已商用化
- Prefill / decode
- prefill 處理使用者輸入、可平行、吃算力;decode 逐 token 輸出、循序、吃記憶體
- MoE
- 每個 token 只啟動一部分專家,用小模型的算力成本換大模型的智慧
- REAP
- router weighted expert activation pruning,把沒被啟動的專家修剪掉
- KV cache 重用
- 儲存並重用已算過的 token 表示,不必每一步重算注意力
- Compaction
- context 填滿後被壓縮、資訊可能流失的機制,Sarah 建議避開 80% 到 100% 的區間
- 四檔案外部記憶
- agents、plan、progress、verify 四個 MD 檔,讓每個新 session 接得上進度